YARA는 파일 안의 문자열이나 바이트 패턴을 조건식으로 적어 파일을 분류하는 오픈소스 도구입니다. 악성코드 분석가와 보안관제 팀이 "이 특징이 있는 파일을 찾아라"를 룰로 공유할 때 씁니다. 이 글에서는 실제 악성코드 대신 무해한 표식 문자열로 룰 작성, 스캔, 오류 읽기를 해 봅니다.
준비물
| 항목 | 확인한 값 |
|---|---|
| Python | 3.12.10 |
| 라이브러리 | yara-python 4.5.4 (pip install yara-python) |
1. 룰과 샘플
rules.yar에 룰 두 개를 둡니다.
rule Demo_Marker_Script
{
    meta:
        description = "demo marker strings in a script"
    strings:
        $a = "Invoke-DemoPayload" ascii nocase
        $b = "DEMO_STAGE_TWO" ascii
    condition:
        any of them
}

rule Beacon_Config
{
    strings:
        $k = "C2_BEACON_INTERVAL" ascii
        $u = "LabTestAgent" ascii
    condition:
        all of them
}
샘플은 samples/ 폴더의 텍스트 파일 세 개입니다. clean.txt는 평범한 문장, script1.txt에는 Invoke-DemoPayload, config.txt에는 C2_BEACON_INTERVAL과 LabTestAgent가 둘 다 들어 있습니다.
2. 스캔
import yara, pathlib
rules = yara.compile(filepath="rules.yar")
for p in sorted(pathlib.Path("samples").iterdir()):
    m = rules.match(str(p))
    print(p.name, "->", [x.rule for x in m] or "no match")
# 기대 출력(이 PC)
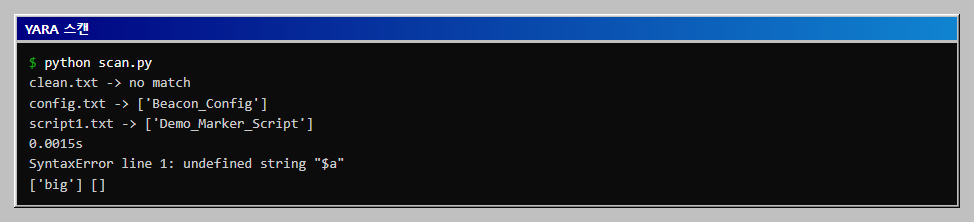
clean.txt -> no match
config.txt -> ['Beacon_Config']
script1.txt -> ['Demo_Marker_Script']
파일 세 개를 스캔하는 데 0.001초가 걸렸지만 작은 파일이라 성능을 판단할 근거는 되지 못합니다. 아래 캡처는 다시 실행한 것이라 0.0015초로 찍혀 있습니다.
3. 조건 읽기
any of them은 문자열 하나만 맞아도 걸립니다.script1.txt에는$a만 있는데 걸렸습니다.all of them은 전부 맞아야 걸립니다.Beacon_Config는 두 문자열이 함께 있는 파일만 잡습니다. 한 문자열만 있는 파일을 걸리게 하면 오탐이 늘어서 보통 이쪽을 씁니다.- 횟수 조건:
#s > 2는 문자열$s가 두 번 넘게 나와야 합니다."A"한 글자를 찾는 룰에AAAB를 넣으면 걸리고(['big'])AB를 넣으면 안 걸렸습니다([]).
4. 오류 읽기
정의하지 않은 문자열을 조건에 쓰면 컴파일 단계에서 막힙니다.
yara.compile(source='rule x { condition: $a }')
# 기대 출력
SyntaxError line 1: undefined string "$a"
룰을 스캔에 쓰기 전에 컴파일만 먼저 돌려 보는 검사를 CI에 넣을 수 있습니다.
5. 한계
문자열 룰은 쉽게 우회됩니다. 공격자가 문자열을 인코딩하거나 이름을 바꾸면 못 잡고, 반대로 보안 글이나 로그에 같은 문자열이 있으면 오탐이 납니다. 룰은 그 파일이 악성이라는 증거가 아니라 "이 특징이 있다"는 표시입니다. 이 글의 룰은 표식 문자열 전용이라 실제 위협 탐지 성능은 말할 수 없습니다.
더 해 보기: 16진수 패턴, 정규식, wide 문자열, 개수와 위치 조건, 속도
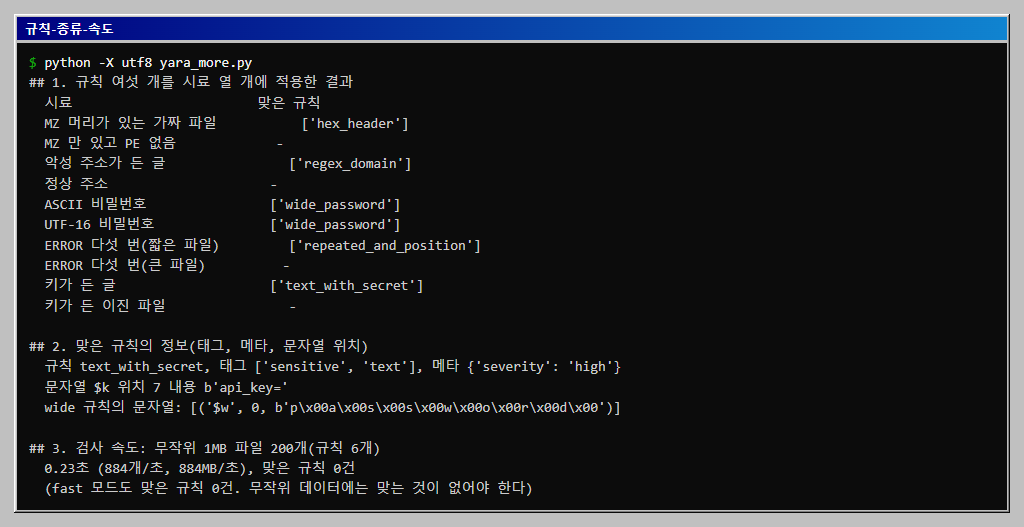
위에서는 글자 그대로 찾는 문자열 조건을 썼습니다. YARA 규칙에는 이 밖에 바이트 패턴, 정규식, UTF-16으로 저장된 글자, 개수와 위치 조건, 다른 규칙을 부품으로 쓰는 private 규칙이 있습니다. 여섯 가지 규칙을 만들어 시료 열 개에 적용하고 검사 속도도 쟀습니다(yara_more.py). 시료는 모두 이 파일 안에서 만든 짧은 바이트열이며 실제 악성코드가 아닙니다.
규칙 여섯 개
| 규칙 | 무엇을 찾나 | 핵심 문법 |
|---|---|---|
hex_header |
파일 맨 앞이 MZ이고 그 뒤 2~60바이트를 건너 PE\0\0이 오는 것(실행 파일 머리 모양) |
{ 4D 5A [2-60] 50 45 00 00 }, $mz at 0 |
regex_domain |
.ru나 .cn 도메인으로 가는 주소 |
/https?:\/\/...\.(ru|cn)\/.../ nocase |
wide_password |
password를 ASCII와 UTF-16 두 가지 모양으로 |
ascii nocase와 wide nocase, any of them |
repeated_and_position |
ERROR가 3번보다 많고, 첫 위치가 20 안이고, 파일이 1KB보다 작은 것 |
#x > 3 and @x[1] < 20 and filesize < 1KB |
is_text (private) |
첫 바이트가 화면에 보이는 글자인가 | uint8(0) >= 0x20 and uint8(0) < 0x7f |
text_with_secret |
텍스트이면서 api_key=가 든 것 |
is_text and $k, 태그 sensitive, text와 메타 severity |
열 개 시료의 결과
| 시료 | 맞은 규칙 |
|---|---|
| MZ와 PE 표시가 있는 가짜 파일 | hex_header |
| MZ만 있고 PE가 없음 | 없음 |
http://bad-site.example.ru/dl/run_me가 든 글 |
regex_domain |
http://good.example.com/about |
없음 |
the Password is hidden (대문자 P) |
wide_password |
password를 UTF-16으로 인코딩한 바이트 |
wide_password |
| ERROR 5번, 짧은 파일 | repeated_and_position |
| ERROR 5번, 뒤에 공백 2,000개를 붙인 큰 파일 | 없음 |
config api_key=ABC123 end |
text_with_secret |
\x00\x01api_key=ABC123 (이진 파일) |
없음 |
- 같은 글자를 담은 두 시료가 다르게 판정되었습니다. ERROR 5번이 든 두 시료는 파일 크기 조건(1KB보다 작은 것)만 달라서 하나만 맞았습니다.
api_key=가 든 두 시료도 앞에 붙은 바이트(\x00)가 텍스트 조건(is_text)에 걸려 이진 파일 쪽은 맞지 않았습니다. 규칙 조건 하나가 결과를 이렇게 갈라놓으므로, 새 규칙을 만들면 맞아야 하는 시료와 맞지 않아야 하는 시료를 함께 만들어 시험합니다. nocase와wide는 따로 챙겨야 합니다. 대문자가 섞인Password는nocase덕분에 맞았고, UTF-16으로 저장된password는wide가 있어야 맞았습니다. 윈도우 프로그램은 글자를 UTF-16으로 저장하는 경우가 많아서, 문자열을ascii로만 찾으면 놓칠 수 있습니다.- private 규칙은 부품입니다.
is_text는 혼자 결과로 나오지 않고text_with_secret의 조건 안에서만 쓰였습니다. 공통 조건을 이렇게 모아 두면 규칙을 읽기 쉽습니다.
맞은 규칙의 정보
text_with_secret이 맞았을 때 결과 객체에서 읽은 값입니다.
| 항목 | 값 |
|---|---|
| 규칙 이름 | text_with_secret |
| 태그 | sensitive, text |
| 메타 | severity: high |
| 맞은 문자열 | $k, 위치 7, 내용 api_key= |
wide_password가 UTF-16 시료에서 맞았을 때 맞은 바이트는 p\x00a\x00s\x00s\x00...처럼 글자 사이에 0이 낀 모양이었습니다. 보고서에 맞은 내용을 그대로 옮길 때는 이런 모양은 사람이 읽기 어려우니 디코딩해서 적습니다. 태그와 메타는 결과를 분류하고 대응 순서를 정하는 데 씁니다.
검사 속도
무작위 1MB 데이터 200개(합계 200MB)를 여섯 규칙으로 검사하는 데 0.23초가 걸렸습니다. 초당 약 884MB입니다. 맞은 규칙은 0건이었는데, 무작위 데이터에는 이 규칙들이 맞지 않는 것이 정상입니다. fast=True로도 같았습니다. 이 속도는 메모리에 올린 데이터를 검사한 값이어서, 디스크에서 파일을 읽는 시간이 더해지는 실제 폴더 검사에서는 느려집니다. 규칙이 수천 개로 늘면 시간도 늘어나므로 그때는 직접 재어 봅니다. 이 글에서는 디스크의 파일 검사와 많은 규칙의 속도는 시험하지 않았습니다.
yara_more.py는 아래와 같습니다.
"""YARA 심화: 16진수 패턴, 정규식, nocase/wide, 개수와 위치 조건, private 규칙, 검사 속도.

준비: pip install yara-python
주의: 모든 검사 대상은 이 파일 안에서 만든 문자열이다. 실제 악성코드를 쓰지 않는다.
실행: python -X utf8 yara_more.py   (약 10초)
"""
import os
import time

import yara

RULES = r'''
rule hex_header {
    meta: purpose = "실행 파일 머리(MZ 와 PE 표시)를 16진수로 찾는다"
    strings:
        $mz = { 4D 5A [2-60] 50 45 00 00 }          // MZ, 임의 2~60바이트, PE\0\0
    condition: $mz at 0
}
rule regex_domain {
    strings:
        $d = /https?:\/\/[a-z0-9.\-]+\.(ru|cn)\/[a-z0-9\/_]*/ nocase
    condition: $d
}
rule wide_password {
    strings:
        $a = "password" ascii nocase
        $w = "password" wide nocase
    condition: any of them
}
rule repeated_and_position {
    strings:
        $x = "ERROR"
    condition: #x > 3 and @x[1] < 20 and filesize < 1KB
}
private rule is_text {
    condition: uint8(0) >= 0x20 and uint8(0) < 0x7f
}
rule text_with_secret : sensitive text {
    meta: severity = "high"
    strings: $k = "api_key="
    condition: is_text and $k
}
'''
rules = yara.compile(source=RULES)

SAMPLES = {
    "MZ 머리가 있는 가짜 파일": b"MZ" + b"\x90\x00\x03\x00" + b"\x00" * 20 + b"PE\x00\x00" + b"data",
    "MZ 만 있고 PE 없음": b"MZ" + b"\x90\x00" * 30,
    "악성 주소가 든 글": b"visit http://bad-site.example.ru/dl/run_me now",
    "정상 주소": b"visit http://good.example.com/about",
    "ASCII 비밀번호": b"the Password is hidden",
    "UTF-16 비밀번호": "password".encode("utf-16-le"),
    "ERROR 다섯 번(짧은 파일)": b"ERROR a ERROR b ERROR c ERROR d ERROR e",
    "ERROR 다섯 번(큰 파일)": b"ERROR a ERROR b ERROR c ERROR d ERROR e" + b" " * 2000,
    "키가 든 글": b"config api_key=ABC123 end",
    "키가 든 이진 파일": b"\x00\x01api_key=ABC123",
}
print("## 1. 규칙 여섯 개를 시료 열 개에 적용한 결과")
print(f"  {'시료':<26}맞은 규칙")
for name, data in SAMPLES.items():
    m = rules.match(data=data)
    print(f"  {name:<26}{[x.rule for x in m] or '-'}")

print("\n## 2. 맞은 규칙의 정보(태그, 메타, 문자열 위치)")
m = rules.match(data=SAMPLES["키가 든 글"])[0]
print(f"  규칙 {m.rule}, 태그 {m.tags}, 메타 {m.meta}")
for sm in m.strings:
    for inst in sm.instances:
        print(f"  문자열 {sm.identifier} 위치 {inst.offset} 내용 {inst.matched_data!r}")
w = rules.match(data=SAMPLES["UTF-16 비밀번호"])[0]
print(f"  wide 규칙의 문자열: {[(s.identifier, i.offset, i.matched_data) for s in w.strings for i in s.instances]}")

print("\n## 3. 검사 속도: 무작위 1MB 파일 200개(규칙 6개)")
blobs = [os.urandom(1_000_000) for _ in range(200)]
t = time.time()
hits = sum(len(rules.match(data=b)) for b in blobs)
dt = time.time() - t
print(f"  {dt:.2f}초 ({200 / dt:.0f}개/초, {200 / dt:.0f}MB/초), 맞은 규칙 {hits}건")
fast = sum(len(rules.match(data=b, fast=True)) for b in blobs[:10])
print(f"  (fast 모드도 맞은 규칙 {fast}건. 무작위 데이터에는 맞는 것이 없어야 한다)")
전체 코드
아래 파일들을 다음 구조로 한 폴더에 저장하고 python -X utf8 scan.py로 실행하면 이 글의 모든 결과(분류, 문법 오류, 횟수 조건)가 나옵니다. pip install yara-python이 먼저 필요합니다.
yara-lab/
  rules.yar
  scan.py
  samples/
    clean.txt
    script1.txt
    config.txt
# scan.py
import yara, pathlib, time
rules = yara.compile(filepath="rules.yar")
t = time.time()
for p in sorted(pathlib.Path("samples").iterdir()):
    m = rules.match(str(p))
    print(p.name, "->", [x.rule for x in m] or "no match")
print("%.4fs" % (time.time() - t))

try:
    yara.compile(source='rule x { condition: $a }')
except Exception as e:
    print(type(e).__name__, e)

r = yara.compile(source='rule big { strings: $s = "A" condition: #s > 2 }')
print([m.rule for m in r.match(data=b"AAAB")], [m.rule for m in r.match(data=b"AB")])
rules.yar
rule Demo_Marker_Script
{
    meta:
        description = "demo marker strings in a script"
    strings:
        $a = "Invoke-DemoPayload" ascii nocase
        $b = "DEMO_STAGE_TWO" ascii
    condition:
        any of them
}

rule Beacon_Config
{
    strings:
        $k = "C2_BEACON_INTERVAL" ascii
        $u = "LabTestAgent" ascii
    condition:
        all of them
}
samples/clean.txt
hello world, nothing here
samples/script1.txt
powershell -enc SQBFAFgA ; Invoke-DemoPayload -Mode test
samples/config.txt
config: C2_BEACON_INTERVAL=60 ; user-agent: LabTestAgent
자주 막히는 곳
| 증상 | 원인과 해결 |
|---|---|
undefined string 오류 |
조건에 쓴 $이름을 strings:에 정의했는지 봅니다 |
| 대소문자만 달라 걸리지 않음 | 문자열 뒤에 nocase를 붙입니다 |
| 한글이 걸리지 않음 | 파일 인코딩에 따라 바이트가 다릅니다. wide나 UTF-8 바이트로 따로 적어야 하며 이 글에서는 확인하지 않았습니다 |
| 실제 악성 도구 이름을 넣은 명령이 실행되지 않음 | 처음 시도한 명령은 셸 실행 단계에서 거부됐고(원인은 확인하지 않았습니다), 표식 문자열로 바꾸자 실행됐습니다. 분석용 문자열은 파일로 따로 만들어 둡니다 |
확인 범위
- 해 본 것: 2026-10-29에 yara_more.py로 규칙 여섯 종류를 시료 열 개에 적용하고 검사 속도를 쟀습니다. 앞의 확인 내용은 다음과 같습니다. 2026-10-28, Windows 11 · Python 3.12.10 · yara-python 4.5.4에서 위 룰 두 개와 샘플 세 개를 한 번 스캔했습니다.
- 해 보지 않은 것: 디스크의 실제 파일 폴더 검사 속도, 규칙 수천 개의 속도, 모듈(pe, math), 실제 악성코드 샘플, 룰 저장소 활용, 대용량 스캔 성능.
- 읽을 때 주의: 룰과 샘플은 직접 만든 무해한 표식 문자열입니다.
이 글의 다음 단계
- GitHub Dependabot 켜기: 취약한 의존성 알림과 자동 수정 PR 받기오래된 버전을 고정한 requirements.txt를 시험 저장소에 넣고 Dependency graph, Dependabot alerts, Dependabot security updates를 켭니다. 알림 47건이 뜨는 것과 Dependabot이 올린 수정 풀 리퀘스트를 확인하고, 하나를 병합해 열린 알림이 36건으로 줄어드는 것까지 봅니다.
- GitHub ruleset으로 main 보호: 직접 푸시와 강제 푸시 막기GitHub 저장소에 ruleset을 만들어 main 브랜치의 삭제, 직접 푸시, 강제 푸시를 막습니다. 규칙을 켠 뒤 직접 푸시와 강제 푸시가 GH013 오류로 거부되는 것을 확인하고, 풀 리퀘스트로는 같은 변경이 들어가는 것까지 시험합니다.
이 내용을 팀 교육으로 진행하고 싶으신가요?
인원, 수준, 일정에 맞춰 실습 환경까지 준비해 진행합니다. 대상과 기간을 알려 주시면 구성을 제안해 드립니다.
교육 문의하기메일로 보내실 수도 있습니다: fankh111@gmail.com