챗봇처럼 쓰려면 두 가지가 필요합니다. 답이 만들어지는 대로 보여 주는 스트리밍, 그리고 앞에서 한 이야기를 기억하는 대화 세션입니다. 이 글에서는 Gemini API로 둘을 차례로 해 봅니다.
준비물
| 항목 | 확인한 값 |
|---|---|
| Python | 3.12.10, google-genai 2.24.0 |
| 모델 | gemini-2.5-flash-lite |
| 키 | 환경 변수 GEMINI_API_KEY |
1. 스트리밍
generate_content_stream은 답을 조각(chunk)으로 나눠 돌려줍니다.
import time
from google import genai

c = genai.Client()
M = "gemini-2.5-flash-lite"
t = time.time(); first = None; n = 0; txt = ""
for ch in c.models.generate_content_stream(
        model=M, contents="로컬 AI와 클라우드 AI의 차이를 두 문장으로 설명해 주세요."):
    if ch.text and first is None:
        first = time.time() - t
    n += 1
    txt += ch.text or ""
print("first %.2fs chunks %d total %.2fs" % (first, n, time.time() - t))
print(txt.strip())
# 기대 출력(이 PC)
first 0.62s chunks 4 total 1.00s
로컬 AI는 개인 장치의 처리 능력을 활용하여 ... 클라우드 AI는 원격 서버에 데이터를 업로드하여 ...
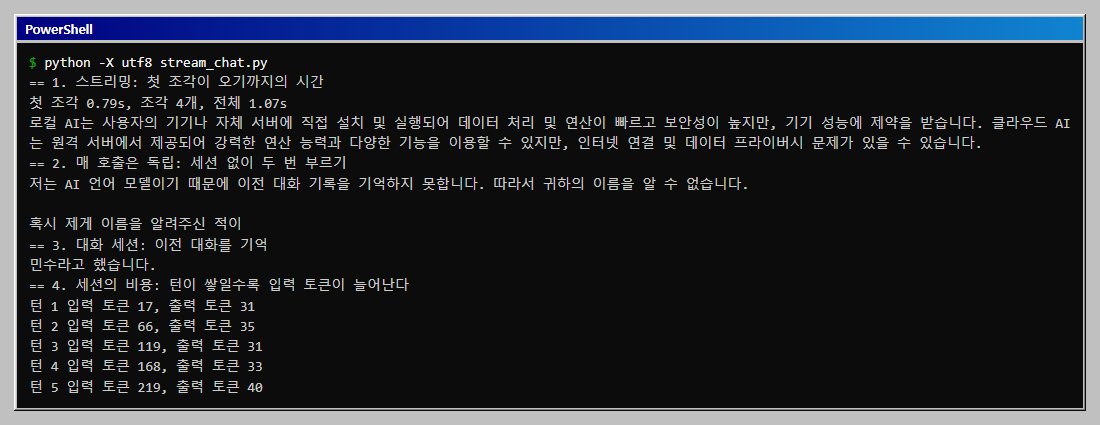
첫 조각이 0.62초에 도착했고 전체는 1.00초에 끝났습니다. 조각은 4개뿐이었습니다. 답이 두 문장으로 짧아서 스트리밍의 이점이 크지 않았고, 긴 답일수록 첫 글자가 빨리 보이는 효과가 커집니다. 로컬 Ollama 글에서는 같은 방식으로 조각이 159개 왔습니다. 조각 수와 크기는 서비스마다 다르며 이 실행에서는 조각이 훨씬 컸습니다.
2. 매 호출은 독립입니다
generate_content를 두 번 부르면 두 번째는 첫 번째를 모릅니다. 대화를 이어 가려면 이전 질문과 답을 매번 함께 보내야 합니다. 세션 객체가 이 일을 대신합니다.
chat = c.chats.create(model=M)
chat.send_message("제 이름은 민수입니다. 기억해 주세요.")
print(chat.send_message("제 이름이 뭐라고 했죠?").text.strip())
# 기대 출력
민수님이라고 했습니다.
두 번째 질문에서 이름을 기억했습니다. 세션이 내부에 대화 기록을 쌓아 두었다가 다음 요청에 같이 보내기 때문입니다.
3. 세션의 비용
세션의 기억은 마법이 아니라 보내는 내용이 늘어난 결과입니다. 같은 세션에서 "보안 점검 항목 N번째를 한 문장으로 알려 주세요"를 5번 보내며 응답의 usage_metadata.prompt_token_count를 기록했습니다.
| 턴 | 입력 토큰 | 출력 토큰 |
|---|---|---|
| 1 | 17 | 31 |
| 2 | 66 | 35 |
| 3 | 119 | 31 |
| 4 | 168 | 33 |
| 5 | 219 | 40 |
질문은 매번 비슷한 길이인데 입력 토큰은 17에서 219로 늘었습니다. 이전 질문과 답이 계속 함께 전송되기 때문입니다. 턴마다 약 50토큰씩 늘어난 것은 이 짧은 질문 기준이며, 긴 답변이 오가는 대화에서는 증가 폭이 훨씬 클 수 있습니다. 비용을 줄이려면 오래된 턴을 요약해 대체하거나 세션을 새로 시작하는 방법이 있지만, 이 글에서는 시험하지 않았습니다.
세션 없이 generate_content를 두 번 부른 경우에는 두 번째 호출이 "이전 대화 기록을 기억하지 못합니다"라고 답했습니다. 2번의 독립 호출이라는 설명이 실제로 확인된 것입니다.
더 해 보기: 첫 글자까지의 시간, 조각 통계, 중간에 멈추기, 기록을 자르면
위 5턴 실험은 대화 기록이 쌓일수록 입력 토큰이 늘어나는 것을 보여 주었습니다. 이번에는 스트리밍이 사용자가 느끼는 속도를 얼마나 바꾸는지, 조각이 어떻게 오는지, 중간에 멈추면 어떻게 되는지, 그리고 비용을 줄이려고 기록을 자르면 무엇을 잊는지를 확인했습니다(stream_more.py). 생각(thinking)은 끄고(thinking_budget=0) 같은 모델(gemini-2.5-flash-lite)로 했습니다.
스트리밍이 줄이는 것: 기다리는 느낌
"로컬 AI와 클라우드 AI를 네 가지 면에서 자세히 설명하라"는 긴 질문을 네 번씩 보냈습니다.
| 방식 | 사용자가 처음 글자를 보기까지 | 전체가 끝나기까지(중앙값) |
|---|---|---|
| 스트리밍 | 0.69초 | 9.15초 |
| 한 번에 받기 | 11.02초(그동안 화면에 아무것도 없음) | 11.02초 |
전체 시간은 비슷해 보이지만(9초와 11초), 사용자가 느끼는 차이는 0.69초와 11초입니다. 스트리밍은 답이 끝나는 시간을 줄이는 것이 아니라 첫 글자를 보여 주는 시간을 거의 없애는 방법입니다. 답이 길수록, 사람이 화면 앞에서 기다릴수록 효과가 큽니다. 프로그램이 답을 통째로 받아 다음 처리로 넘기는 일이라면 스트리밍의 이득이 없고 코드만 복잡해집니다.
조각은 이렇게 옵니다
마지막 스트리밍 한 번에서 조각 통계를 냈습니다.
| 항목 | 값 |
|---|---|
| 조각 수 | 49개 |
| 평균 길이 | 99글자 |
| 가장 긴 조각 | 117글자 |
| 첫 조각 | 11글자 |
조각은 글자 단위가 아니라 문장 일부 정도의 덩어리(평균 99글자)로 옵니다. 첫 조각은 짧고(11글자) 이후는 100글자 안팎이었습니다. 그래서 화면에 글자를 한 자씩 타자 효과로 보여 주려면 받은 조각을 클라이언트에서 다시 나누어 출력합니다. 조각 경계는 단어나 문장 경계와 맞지 않을 수 있으므로, 조각마다 마크다운을 해석하면 **가 반으로 갈라져 깨져 보일 수 있습니다. 이 글에서는 이 현상을 직접 확인하지 않았습니다.
중간에 멈추기
세 번째 조각까지만 받고 반복문을 break했더니 0.88초 만에 142글자를 받고 끝났습니다. 끝까지 받으면 약 9초가 걸리는 답입니다. 사용자가 "중지" 버튼을 누르는 경우나 원하는 정보를 이미 얻은 경우에 시간을 아낄 수 있습니다. 끊는다고 서버 쪽 비용이 사라지는지는 이 글에서 확인하지 않았습니다. 끊은 뒤에도 서버가 얼마까지 생성했는지, 어디까지 요금에 포함되는지는 요금 안내를 따로 확인합니다.
기록을 자르면 잊습니다
5턴 대화에서 첫 턴에 "제 이름은 지훈이고 가장 좋아하는 숫자는 47입니다"라고 알려 주었습니다. 마지막 턴에서 그것을 물었습니다.
| 기록 | 마지막 턴 입력 토큰 | 답 |
|---|---|---|
| 전부 유지 | 180 | 당신의 이름은 지훈이고, 가장 좋아하는 숫자는 47입니다. |
| 가장 최근 몇 번만 남김 | 79 | 이전 대화 내용을 기억하지 못한다며 이름과 숫자를 다시 물음 |
기록을 자르면 입력 토큰이 180에서 79로 줄었지만, 앞에서 알려 준 이름과 숫자를 잊었습니다. 모델에게는 "기억"이 따로 없고 매번 보낸 기록이 전부입니다. 비용을 줄이려고 기록을 자를 때는 오래된 대화를 그냥 버리지 말고, 지켜야 할 사실(이름, 설정, 결정 사항)을 요약해 맨 앞에 남겨 두는 방법을 씁니다. 이 요약 방식은 이 글에서 시험하지 않았습니다.
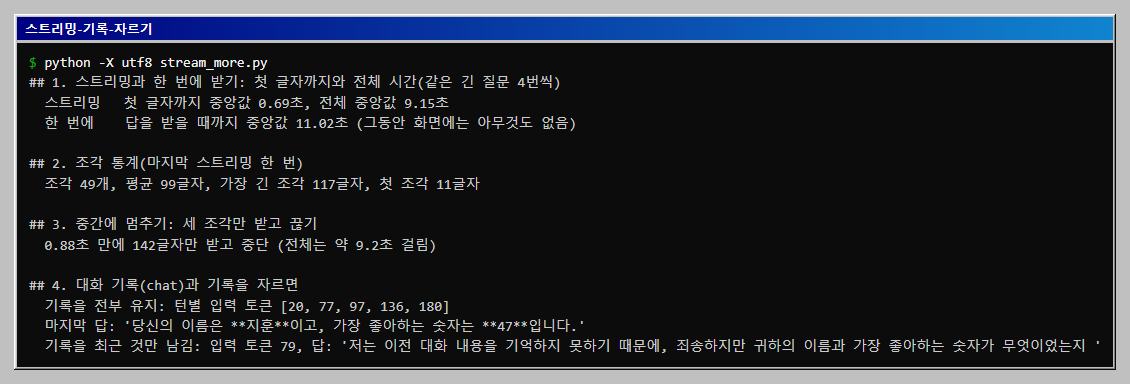
stream_more.py는 아래와 같습니다. 호출을 20번 안팎 보냅니다.
"""Gemini 스트리밍과 대화 기록 심화: 첫 조각까지의 시간, 조각 통계, 중간에 멈추기, 기록을 잘랐을 때 잊는 것.

준비: pip install google-genai, 환경 변수 GEMINI_API_KEY (코드에 적지 않는다)
실행: python -X utf8 stream_more.py   (약 1분)
"""
import statistics
import time

from google import genai
from google.genai import types

MODEL = "gemini-2.5-flash-lite"
c = genai.Client()
LONG = "로컬 AI와 클라우드 AI를 보안, 비용, 속도, 관리 네 가지 면에서 비교해 자세히 설명해 주세요."
CFG = types.GenerateContentConfig(thinking_config=types.ThinkingConfig(thinking_budget=0))

print("## 1. 스트리밍과 한 번에 받기: 첫 글자까지와 전체 시간(같은 긴 질문 4번씩)")
first, total_s, total_n = [], [], []
chunks_info = None
for _ in range(4):
    t = time.time()
    f = None
    n = 0
    sizes = []
    for ch in c.models.generate_content_stream(model=MODEL, contents=LONG, config=CFG):
        if f is None and ch.text:
            f = time.time() - t
        n += 1
        sizes.append(len(ch.text or ""))
    first.append(f)
    total_s.append(time.time() - t)
    chunks_info = (n, sizes)
for _ in range(4):
    t = time.time()
    c.models.generate_content(model=MODEL, contents=LONG, config=CFG)
    total_n.append(time.time() - t)
print(f"  스트리밍   첫 글자까지 중앙값 {statistics.median(first):.2f}초, 전체 중앙값 {statistics.median(total_s):.2f}초")
print(f"  한 번에    답을 받을 때까지 중앙값 {statistics.median(total_n):.2f}초 (그동안 화면에는 아무것도 없음)")

print("\n## 2. 조각 통계(마지막 스트리밍 한 번)")
n, sizes = chunks_info
print(f"  조각 {n}개, 평균 {statistics.mean(sizes):.0f}글자, 가장 긴 조각 {max(sizes)}글자, 첫 조각 {sizes[0]}글자")

print("\n## 3. 중간에 멈추기: 세 조각만 받고 끊기")
t = time.time()
got = ""
for i, ch in enumerate(c.models.generate_content_stream(model=MODEL, contents=LONG, config=CFG)):
    got += ch.text or ""
    if i == 2:
        break
print(f"  {time.time() - t:.2f}초 만에 {len(got)}글자만 받고 중단 (전체는 약 {statistics.median(total_s):.1f}초 걸림)")

print("\n## 4. 대화 기록(chat)과 기록을 자르면")
chat = c.chats.create(model=MODEL, config=CFG)
turns = ["제 이름은 지훈이고 가장 좋아하는 숫자는 47입니다. 기억해 주세요.",
         "대한민국의 수도는 어디인가요? 한 단어로.", "파이썬에서 리스트를 뒤집는 방법을 한 줄로 알려 주세요.",
         "HTTP 상태 코드 404는 무슨 뜻인가요? 한 문장으로.", "마지막으로, 제 이름과 가장 좋아하는 숫자가 뭐였죠?"]
ptoks = []
for q in turns:
    r = chat.send_message(q)
    ptoks.append(r.usage_metadata.prompt_token_count)
print(f"  기록을 전부 유지: 턴별 입력 토큰 {ptoks}")
print(f"  마지막 답: {r.text.strip()[:60]!r}")
hist = chat.get_history()
short = c.chats.create(model=MODEL, config=CFG, history=hist[-4:-1] if len(hist) >= 4 else hist)   # 최근 두 번의 주고받기만
r2 = short.send_message(turns[-1])
print(f"  기록을 최근 것만 남김: 입력 토큰 {r2.usage_metadata.prompt_token_count}, 답: {r2.text.strip()[:60]!r}")
전체 코드
아래 파일은 스트리밍, 세션 없는 호출, 대화 세션, 5턴 토큰 증가를 차례로 실행합니다. 그대로 복사해 stream_chat.py로 저장하고 python -X utf8 stream_chat.py로 실행합니다.
# stream_chat.py
"""Gemini API 스트리밍, 대화 세션, 대화가 길어질 때 입력 토큰이 느는 모습을 확인한다.

준비:
  pip install google-genai
  환경 변수 GEMINI_API_KEY 에 키를 넣어 둔다.
실행:
  python -X utf8 stream_chat.py
"""
import time
from google import genai

MODEL = "gemini-2.5-flash-lite"
c = genai.Client()

print("== 1. 스트리밍: 첫 조각이 오기까지의 시간")
t = time.time()
first = None
n = 0
txt = ""
for ch in c.models.generate_content_stream(
        model=MODEL, contents="로컬 AI와 클라우드 AI의 차이를 두 문장으로 설명해 주세요."):
    if ch.text and first is None:
        first = time.time() - t
    n += 1
    txt += ch.text or ""
print("첫 조각 %.2fs, 조각 %d개, 전체 %.2fs" % (first, n, time.time() - t))
print(txt.strip())

print("== 2. 매 호출은 독립: 세션 없이 두 번 부르기")
c.models.generate_content(model=MODEL, contents="제 이름은 민수입니다. 기억해 주세요.")
print(c.models.generate_content(model=MODEL, contents="제 이름이 뭐라고 했죠?").text.strip()[:80])

print("== 3. 대화 세션: 이전 대화를 기억")
chat = c.chats.create(model=MODEL)
chat.send_message("제 이름은 민수입니다. 기억해 주세요.")
print(chat.send_message("제 이름이 뭐라고 했죠?").text.strip())

print("== 4. 세션의 비용: 턴이 쌓일수록 입력 토큰이 늘어난다")
chat = c.chats.create(model=MODEL)
for i in range(1, 6):
    r = chat.send_message("보안 점검 항목 %d번째를 한 문장으로 알려 주세요." % i)
    print("턴 %d 입력 토큰 %s, 출력 토큰 %s"
          % (i, r.usage_metadata.prompt_token_count, r.usage_metadata.candidates_token_count))
자주 막히는 곳
| 증상 | 원인과 해결 |
|---|---|
| 세션이 이름을 기억하지 못함 | send_message마다 새 세션을 만들었는지 확인합니다. 같은 chat 객체를 계속 씁니다 |
| 스트리밍인데 한 번에 나옴 | 답이 짧으면 조각이 적어 그렇게 보입니다 |
| 프로그램을 껐더니 대화가 사라짐 | 세션은 메모리에만 있습니다. 이어 가려면 기록을 직접 저장했다가 다시 넣어야 하는데, 이 글에서는 확인하지 않았습니다 |
확인 범위
- 해 본 것: 29일에 stream_more.py로 스트리밍과 한 번에 받기의 시간, 조각 통계, 중간 중단, 대화 기록을 잘랐을 때의 답을 확인했습니다. 앞의 확인 내용은 다음과 같습니다. 2026-10-28과 29일, Windows 11 · Python 3.12.10 ·
google-genai2.24.0 ·gemini-2.5-flash-lite로 본문 코드를 한 번 실행했고, 29일에 위 전체 코드를 다시 실행해 5턴 토큰 증가를 쟀습니다. - 해 보지 않은 것: 중단한 뒤의 서버 쪽 요금, 기록을 요약해 앞에 두는 방식, 조각 경계에서 마크다운이 깨지는 현상, 긴 답변이 오가는 대화의 토큰 증가, 세션 기록 저장과 복원, 비동기 호출, 다른 모델.
- 읽을 때 주의: 시간은 한 번 잰 값이며 네트워크 상태에 따라 달라집니다.
이 글의 다음 단계
- 파이썬에서 로컬 Ollama API 호출하기: 응답 받기, JSON 형식 고정, 스트리밍requests만으로 내 PC의 Ollama를 호출합니다. 한 번에 받기, 옵션 넘기기, JSON 스키마로 출력 형식 고정하기, 글자가 나오는 대로 받는 스트리밍을 실행해 결과를 확인합니다. 한글이 깨지는 Windows 함정도 함께 정리합니다.
- 작은 모델의 출력 형식을 고정하기: llama-server의 JSON 스키마와 GBNF 문법프롬프트로 JSON을 부탁하면 1B 모델은 열두 번 중 열 번만 읽히고 한 번도 스키마에 맞지 않았습니다. llama-server의 json_schema와 GBNF 문법으로 출력을 제한하면 어떻게 달라지는지, 형식은 지켜져도 내용의 정확도는 그대로인 점까지 모델 두 개로 비교합니다.
이 내용을 팀 교육으로 진행하고 싶으신가요?
인원, 수준, 일정에 맞춰 실습 환경까지 준비해 진행합니다. 대상과 기간을 알려 주시면 구성을 제안해 드립니다.
교육 문의하기메일로 보내실 수도 있습니다: fankh111@gmail.com