모델의 답을 프로그램이 읽으려면 정해진 형식이어야 합니다. 보통은 프롬프트에 "JSON으로만 답하라"고 적지만, 작은 모델은 이 부탁을 자주 어깁니다. 앞의 Ollama 파이썬 API 글에서는 format에 JSON 스키마를 주어 구조를 고정했습니다. llama.cpp의 llama-server는 한 걸음 더 나아가 모델이 다음 글자를 고르는 단계에서 허용되지 않는 글자를 아예 고를 수 없게 막습니다. 이 글에서는 이 기능으로 같은 문의 열두 건을 분류해 보고, 제한이 있을 때와 없을 때, 큰 모델과 작은 모델의 차이를 숫자로 비교합니다.
준비물
| 항목 | 확인한 값 |
|---|---|
| llama.cpp | 빌드 3980e04d5 (9050), Windows, Vulkan 백엔드 (llama-server.exe) |
| 모델(GGUF) | Llama-3.2-1B-Instruct-Q4_K_M.gguf(약 0.8GB), Qwen2.5-7B-Instruct-Q4_K_M.gguf(약 4.4GB) |
| 파이썬 | 3.12, requests |
서버를 어떻게 띄우는지는 앞의 llama-server 글과 같습니다. 이 글의 스크립트는 127.0.0.1:8093에만 열고, 끝나면 자기가 띄운 서버만 끕니다.
1. 두 가지 제한 방법
| 방법 | 어떻게 주나 | 무엇을 막나 |
|---|---|---|
| JSON 스키마 | 요청의 response_format: {"type": "json_schema", "json_schema": {"schema": ...}} |
스키마에 없는 키, 허용되지 않은 값, 잘못된 JSON 구조 |
| GBNF 문법 | 요청의 grammar 필드(BNF 비슷한 문법 문자열) |
문법에 맞지 않는 모든 글자. 자유롭게 모양을 정할 수 있음 |
둘 다 같은 원리입니다. 모델은 매 단계 가능한 다음 글자마다 점수를 매기는데, 서버가 문법에 어긋나는 글자의 점수를 없애 버립니다. 그래서 틀린 형식은 만들어질 수 없습니다. 모델에게 부탁하는 것이 아니라 강제하는 것입니다.
2. 시험 만들기
고객 문의 열두 건을 분류(결제, 로그인, 배송, 기타)와 우선순위(높음, 보통, 낮음), 한 줄 요약으로 정리하게 했습니다. 문의와 정답 라벨은 직접 만들었습니다. 예를 들면 이런 식입니다.
| 문의 | 정답 분류 | 정답 우선순위 |
|---|---|---|
| 카드 결제가 두 번 됐어요. 빨리 환불해 주세요. | 결제 | 높음 |
| 비밀번호를 바꾸고 싶은데 메뉴를 못 찾겠어요. | 로그인 | 낮음 |
| 택배가 다른 주소로 갔다고 합니다. 어떻게 하죠? | 배송 | 높음 |
| 앱 디자인이 예뻐졌네요. 의견 드립니다. | 기타 | 낮음 |
스키마는 이렇게 썼습니다. enum이 허용되는 값을 한정합니다.
{"type": "object",
 "properties": {"category": {"enum": ["결제", "로그인", "배송", "기타"]},
                "priority": {"enum": ["높음", "보통", "낮음"]},
                "summary": {"type": "string"}},
 "required": ["category", "priority", "summary"], "additionalProperties": false}
GBNF 문법은 더 단순합니다. 분류 라벨 한 단어만 허용합니다.
root ::= "결제" | "로그인" | "배송" | "기타"
판정 기준은 세 가지입니다. JSON으로 읽히는가, 읽혀도 키와 값이 스키마에 맞는가, 분류와 우선순위가 정답과 같은가. 모든 호출은 temperature 0이고 모델마다 한 번씩 실행했습니다.
3. 결과
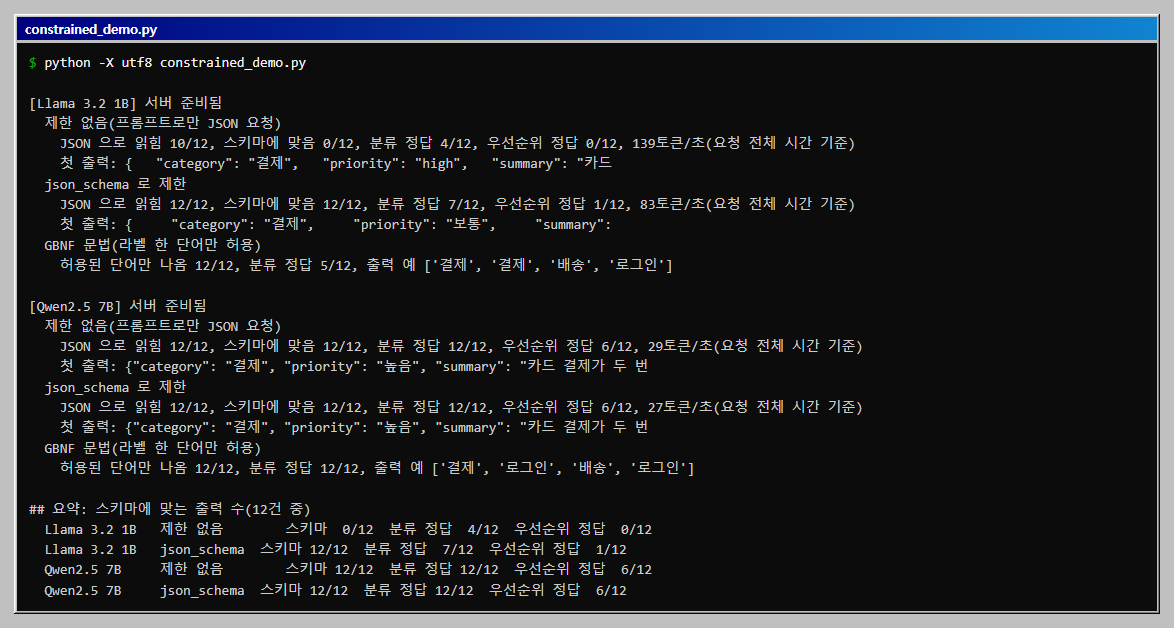
| 모델 | 방식 | JSON으로 읽힘 | 스키마에 맞음 | 분류 정답 | 우선순위 정답 |
|---|---|---|---|---|---|
| Llama 3.2 1B | 제한 없음(프롬프트만) | 10/12 | 0/12 | 4/12 | 0/12 |
| Llama 3.2 1B | json_schema | 12/12 | 12/12 | 7/12 | 1/12 |
| Llama 3.2 1B | GBNF(라벨만) | 허용된 단어만 12/12 | 5/12 | ||
| Qwen2.5 7B | 제한 없음(프롬프트만) | 12/12 | 12/12 | 12/12 | 6/12 |
| Qwen2.5 7B | json_schema | 12/12 | 12/12 | 12/12 | 6/12 |
| Qwen2.5 7B | GBNF(라벨만) | 허용된 단어만 12/12 | 12/12 |
세 가지를 읽을 수 있습니다.
- 1B 모델은 부탁만으로는 형식이 지켜지지 않았습니다. 열두 건 중 열 건만 JSON으로 읽혔고, 읽힌 것도 스키마에 맞는 것은 0건이었습니다. 첫 출력에서
priority값이높음이 아니라 영어high로 나왔습니다. 읽히는 것과 쓸 수 있는 것은 다릅니다. - 제한을 걸자 1B도 형식이 완벽해졌습니다.
json_schema로 열두 건 모두 읽히고 스키마에 맞았습니다. GBNF로는 허용된 라벨 네 개 외의 단어가 한 번도 나오지 않았습니다. - 형식이 맞는 것과 내용이 맞는 것은 다릅니다. 제한을 걸어도 1B의 분류 정답은 7/12, 우선순위 정답은 1/12였습니다. 형식을 강제한 것이지 이해력을 높인 것이 아닙니다. 값이 허용 목록 안에 있어도 얼마든지 틀릴 수 있습니다.
7B 모델은 제한이 없어도 열두 건 모두 형식이 맞았습니다. 큰 모델은 부탁을 잘 따르므로 제한의 이득이 작고, 작은 모델일수록 제한이 필요합니다. 그래도 7B가 이번에 12/12였다고 해서 앞으로도 항상 지킨다는 보장은 없으므로, 프로그램이 읽는 출력이라면 제한을 걸어 두는 편이 안전합니다.
우선순위 정답이 7B도 6/12에 그친 것은 모델의 한계라기보다 정답의 성격 때문일 수 있습니다. 우선순위는 사람마다 기준이 달라 제가 붙인 정답과 다르게 판단할 여지가 큽니다. 이 글에서는 우선순위 열을 "정답이 모호한 항목"으로 보고 분류 열을 기준으로 삼습니다.
4. 속도
같은 열두 건을 처리하는 데 걸린 시간으로 계산한 속도입니다(답 길이를 요청 전체 시간으로 나눈 값이어서 입력 처리 시간이 섞여 있습니다).
| 모델 | 제한 없음 | json_schema |
|---|---|---|
| Llama 3.2 1B | 약 130토큰/초 | 약 83토큰/초 |
| Qwen2.5 7B | 약 29토큰/초 | 약 27토큰/초 |
1B에서는 속도가 크게 줄었고 7B에서는 거의 차이가 없었습니다. 1B에서 줄어든 정도에는 답의 길이 차이도 섞여 있을 수 있습니다. 제한이 없을 때는 중간에 끊긴 답이 짧게 끝나는 경우가 있기 때문입니다. 7B에서는 제한을 걸었다고 눈에 띄게 느려지는 것은 아니었습니다. 한 번씩 잰 값이므로 경향만 봅니다.
5. 어떻게 쓰나
| 상황 | 권하는 방법 |
|---|---|
| 정해진 필드의 JSON이 필요할 때 | json_schema. 값의 종류는 enum으로 한정 |
| 분류나 예/아니오처럼 한 단어면 될 때 | GBNF로 단어 나열. 출력이 짧아 빠름 |
| 정규식에 가까운 모양(날짜, 전화번호) | GBNF로 문법 직접 작성. 이 글에서는 시험하지 않음 |
| 큰 모델을 쓸 때 | 제한이 없어도 잘 지키지만, 프로그램이 읽는 출력이면 제한 적용 |
제한을 걸어도 코드에서 값을 한 번 더 검사하는 습관은 필요합니다. 허용 목록 안의 값이 틀리는 경우와 summary 같은 자유 문장에 이상한 내용이 들어가는 경우는 형식 제한으로 막을 수 없습니다. 값을 쓰기 전에 업무 규칙(예: 이 분류는 이 담당자에게)을 코드로 확인합니다.
전체 코드
위 시험을 한 번에 실행하는 파일입니다. constrained_demo.py로 저장하고 SERVER와 MODELS 경로를 내 PC에 맞게 고친 뒤 python -X utf8 constrained_demo.py로 실행합니다. 이 PC에서는 약 2분이 걸렸습니다. 모델을 두 번 올리고 내리므로 다른 큰 작업과 동시에 돌리지 않는 편이 좋습니다. 문의와 라벨은 실습용으로 만든 것입니다.
"""llama-server 의 출력 제한(JSON 스키마, GBNF 문법)으로 작은 모델의 출력 형식을 고정하고, 제한이 없을 때와 비교한다.

준비: llama.cpp Vulkan 빌드(llama-server.exe), GGUF 모델 두 개, pip install requests
주의: 이 파일이 띄운 서버(127.0.0.1:8093)만 끝낸다. 다른 llama-server 는 건드리지 않는다.
실행: python -X utf8 constrained_demo.py   (약 2분)
"""
import json
import subprocess
import time

import requests

SERVER = r"C:\llama.cpp\llama-server.exe"
MODELS = {"Llama 3.2 1B": r"C:\models\Llama-3.2-1B-Instruct-Q4_K_M.gguf",
          "Qwen2.5 7B": r"C:\models\Qwen2.5-7B-Instruct-Q4_K_M.gguf"}
PORT = 8093
BASE = f"http://127.0.0.1:{PORT}"
CATS = ["결제", "로그인", "배송", "기타"]
PRIS = ["높음", "보통", "낮음"]

# (문의 내용, 정답 분류, 정답 우선순위). 실습용으로 직접 만든 문장과 라벨이다.
TICKETS = [
    ("카드 결제가 두 번 됐어요. 빨리 환불해 주세요.", "결제", "높음"),
    ("비밀번호를 바꾸고 싶은데 메뉴를 못 찾겠어요.", "로그인", "낮음"),
    ("주문한 지 일주일인데 배송이 아직 시작도 안 했습니다.", "배송", "보통"),
    ("로그인이 계속 실패합니다. 내일 아침까지 써야 해요.", "로그인", "높음"),
    ("영수증을 이메일로 다시 받을 수 있나요?", "결제", "낮음"),
    ("택배가 다른 주소로 갔다고 합니다. 어떻게 하죠?", "배송", "높음"),
    ("앱 디자인이 예뻐졌네요. 의견 드립니다.", "기타", "낮음"),
    ("인증 문자가 오지 않아서 가입을 못 하고 있어요.", "로그인", "보통"),
    ("결제 수단을 바꾸고 싶습니다.", "결제", "낮음"),
    ("포장이 심하게 훼손된 채로 왔어요. 교환 부탁드립니다.", "배송", "보통"),
    ("회사 연락처가 어디 있나요?", "기타", "낮음"),
    ("계정이 도용된 것 같아요. 모르는 결제 알림이 왔습니다.", "로그인", "높음"),
]
SYSTEM = ("고객 문의를 분류한다. 분류는 결제, 로그인, 배송, 기타 중 하나이고 "
          "우선순위는 높음, 보통, 낮음 중 하나다. 한 줄 요약도 쓴다. 다른 말은 하지 않는다.")
SCHEMA = {"type": "object",
          "properties": {"category": {"enum": CATS}, "priority": {"enum": PRIS}, "summary": {"type": "string"}},
          "required": ["category", "priority", "summary"], "additionalProperties": False}
# 라벨 한 단어만 허용하는 GBNF 문법(root 가 이 중 하나로만 시작하고 끝난다)
GRAMMAR = 'root ::= "결제" | "로그인" | "배송" | "기타"'


def start(path):
    p = subprocess.Popen([SERVER, "-m", path, "--host", "127.0.0.1", "--port", str(PORT), "-ngl", "99", "-c", "4096"],
                         stdout=subprocess.DEVNULL, stderr=subprocess.DEVNULL)
    for _ in range(90):
        try:
            if requests.get(BASE + "/health", timeout=2).json().get("status") == "ok":
                return p
        except (requests.RequestException, ValueError):
            pass
        time.sleep(1)
    p.kill()
    raise RuntimeError("서버가 시작되지 않았다")


def ask(user, **extra):
    body = {"model": "any", "temperature": 0, "max_tokens": 120,
            "messages": [{"role": "system", "content": SYSTEM}, {"role": "user", "content": user}]}
    body.update(extra)
    t = time.time()
    d = requests.post(BASE + "/v1/chat/completions", json=body, timeout=120).json()
    return d["choices"][0]["message"]["content"], d["usage"]["completion_tokens"], time.time() - t


def judge(text):
    """JSON 으로 읽히는가 / 키와 값이 스키마에 맞는가 -> (읽힘, 맞음, 분류, 우선순위)"""
    try:
        j = json.loads(text)
    except ValueError:
        return False, False, None, None
    ok = (isinstance(j, dict) and j.get("category") in CATS and j.get("priority") in PRIS
          and isinstance(j.get("summary"), str))
    return True, ok, j.get("category") if isinstance(j, dict) else None, j.get("priority") if isinstance(j, dict) else None


MODES = {
    "제한 없음(프롬프트로만 JSON 요청)": lambda u: ask(u + '\n\nJSON 한 개로만 답하라. 키: category, priority, summary.'),
    "json_schema 로 제한": lambda u: ask(u, response_format={"type": "json_schema", "json_schema": {"name": "t", "schema": SCHEMA}}),
}

results = {}
for name, path in MODELS.items():
    srv = start(path)
    try:
        print(f"\n[{name}] 서버 준비됨")
        for mode, fn in MODES.items():
            parsed = valid = cat_ok = pri_ok = toks = 0
            secs = 0.0
            first = None
            for text, cat, pri in [(t[0], t[1], t[2]) for t in TICKETS]:
                out, n, dt = fn(text)
                p, v, c, pr = judge(out)
                parsed += p
                valid += v
                cat_ok += (c == cat)
                pri_ok += (pr == pri)
                toks += n
                secs += dt
                if first is None:
                    first = out.replace("\n", " ")[:60]
            N = len(TICKETS)
            results[(name, mode)] = (parsed, valid, cat_ok, pri_ok, toks / secs)
            print(f"  {mode}\n    JSON 으로 읽힘 {parsed}/{N}, 스키마에 맞음 {valid}/{N}, 분류 정답 {cat_ok}/{N}, 우선순위 정답 {pri_ok}/{N}, {toks / secs:.0f}토큰/초(요청 전체 시간 기준)")
            print(f"    첫 출력: {first}")
        # GBNF 문법: 분류 라벨 한 단어만 허용
        ok = same = 0
        outs = []
        for text, cat, pri in TICKETS:
            out, n, dt = ask(text + "\n분류 하나만 답하라.", grammar=GRAMMAR)
            outs.append(out)
            ok += out in CATS
            same += (out == cat)
        print(f"  GBNF 문법(라벨 한 단어만 허용)\n    허용된 단어만 나옴 {ok}/{len(TICKETS)}, 분류 정답 {same}/{len(TICKETS)}, 출력 예 {outs[:4]}")
    finally:
        srv.terminate()
        srv.wait(timeout=30)
        time.sleep(1)

print("\n## 요약: 스키마에 맞는 출력 수(12건 중)")
for (m, mode), r in results.items():
    print(f"  {m:<14} {'제한 없음' if mode.startswith('제한') else 'json_schema':<12} 스키마 {r[1]:>2}/12  분류 정답 {r[2]:>2}/12  우선순위 정답 {r[3]:>2}/12")
자주 막히는 곳
| 증상 | 원인과 해결 |
|---|---|
grammar 오류나 빈 답이 옵니다 |
문법 문자열에 root ::= 규칙이 없거나 따옴표가 맞지 않는 경우입니다. 한 줄 문법부터 시험합니다 |
| 한글 값을 문법에 쓰면 이상합니다 | 파일을 UTF-8로 저장하고 파이썬은 -X utf8로 실행합니다. 이 글의 문법은 한글 단어를 그대로 썼고 동작했습니다 |
| JSON이 중간에 끊깁니다 | max_tokens가 모자란 경우입니다. 값을 늘립니다 |
| 제한이 없을 때 JSON 앞뒤에 설명이 붙습니다 | 제한을 걸면 사라집니다. 이 글에서 1B의 열두 건 중 두 건이 읽히지 않았던 이유일 수 있으나, 어떤 출력이었는지는 확인하지 않았습니다 |
| 다른 서버가 이미 8093을 씁니다 | PORT를 바꿉니다 |
확인 범위
- 해 본 것: 2026-10-29, Windows 11 · llama.cpp 빌드 9050(Vulkan)에서 모델 두 개로 열두 건 분류를 세 가지 방식으로 실행했습니다. 같은 스크립트를 두 번 실행해 형식과 정답 수가 같았습니다.
- 해 보지 않은 것: 정규식 모양의 문법, 중첩된 스키마, 배열과 선택 항목,
$ref가 있는 스키마, 영어 문의, 더 큰 데이터, 속도의 정밀한 비교(반복 평균). - 읽을 때 주의: 문의 열두 건과 정답은 제가 만든 작은 시험입니다. 우선순위 라벨은 주관적입니다. 모델의 분류 실력 평가가 아니라 형식 제한의 효과를 본 시험입니다.
이 글은 Ollama와 로컬 LLM 실습 로드맵의 한 단계입니다.
이 글의 다음 단계
- llama-server로 내 PC에 OpenAI 호환 API 열기llama.cpp의 llama-server에 GGUF 모델을 올려 OpenAI와 같은 형식의 /v1/chat/completions 주소를 만듭니다. 127.0.0.1에만 열고, requests와 openai 파이썬 라이브러리로 호출해 한 번에 받기와 스트리밍을 확인합니다.
- llama.cpp -ngl로 그래픽 가속 켜고 끄기: 1B와 7B 속도 차이와 중간 값 측정llama-bench의 -ngl 값을 99와 0으로 바꿔 1B와 7B 모델을 재고, 7B는 28층 중 0, 7, 14, 21, 28층만 올린 중간 값도 잽니다. 생성 속도는 2.6배에서 3.2배, 입력 읽기는 2.2배에서 3.1배 차이가 났고, 처음 측정값이 반복 측정에서 재현되지 않은 부분도 정정합니다.
이 내용을 팀 교육으로 진행하고 싶으신가요?
인원, 수준, 일정에 맞춰 실습 환경까지 준비해 진행합니다. 대상과 기간을 알려 주시면 구성을 제안해 드립니다.
교육 문의하기메일로 보내실 수도 있습니다: fankh111@gmail.com