llama.cpp의 -ngl(number of GPU layers) 옵션은 모델의 몇 개 층을 그래픽 쪽에서 계산할지 정합니다. 99처럼 큰 값이면 전부, 0이면 하나도 올리지 않습니다. 그래픽 메모리가 모자랄 때 일부만 올리는 용도로 쓰이는데, 얼마나 차이가 나는지 감을 잡기 위해 켜고 끈 값을 나란히 놓고, 7B 모델은 중간 값도 재 봅니다.
준비물
| 항목 | 확인한 값 |
|---|---|
| llama.cpp | 빌드 3980e04d5 (9050), Windows, Vulkan 빌드 |
| PC | AMD Ryzen AI Max+ 395 (CPU 16코어/32스레드, 내장 그래픽 Radeon 8060S), 메모리 약 96GB |
| 모델 | Llama-3.2-1B-Instruct-Q4_K_M.gguf(763MiB), Qwen2.5-7B-Instruct-Q4_K_M.gguf(4.36GiB, 28층) |
1. 측정
같은 명령을 두 값으로 실행합니다. -p 256은 입력 256토큰 읽기, -n 32는 32토큰 생성입니다.
./llama-bench.exe -m Llama-3.2-1B-Instruct-Q4_K_M.gguf -m Qwen2.5-7B-Instruct-Q4_K_M.gguf -ngl 99 -p 256 -n 32 -r 1
./llama-bench.exe -m Llama-3.2-1B-Instruct-Q4_K_M.gguf -m Qwen2.5-7B-Instruct-Q4_K_M.gguf -ngl 0  -p 256 -n 32 -r 1
2. 결과: 켠 것과 끈 것
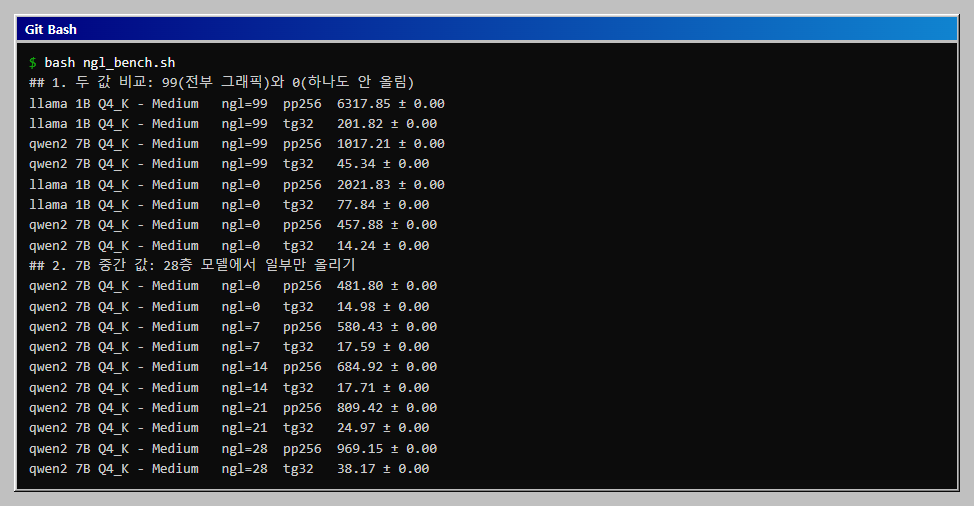
아래 표는 2026-10-29에 전체 스크립트를 실행한 값입니다(아래 "전체 코드" 참고).
| 모델 | ngl | 입력 읽기 pp256 | 생성 tg32 |
|---|---|---|---|
| Llama 3.2 1B | 99 | 6,318토큰/초 | 201.8토큰/초 |
| Llama 3.2 1B | 0 | 2,022토큰/초 | 77.8토큰/초 |
| Qwen2.5 7B | 99 | 1,017토큰/초 | 45.3토큰/초 |
| Qwen2.5 7B | 0 | 458토큰/초 | 14.2토큰/초 |
| 모델 | 생성 속도 배율(99 대비 0) | 입력 읽기 배율 |
|---|---|---|
| 1B | 201.8 / 77.8, 약 2.6배 | 6,318 / 2,022, 약 3.1배 |
| 7B | 45.3 / 14.2, 약 3.2배 | 1,017 / 458, 약 2.2배 |
3. 중간 값: 일부만 올리면 어떻게 되나
Qwen2.5 7B는 28층입니다. 올리는 층 수를 0, 7, 14, 21, 28로 바꿔 쟀습니다.
| 올린 층 | 입력 읽기 pp256 | 생성 tg32 |
|---|---|---|
| 0 | 482토큰/초 | 15.0토큰/초 |
| 7 | 580토큰/초 | 17.6토큰/초 |
| 14 | 685토큰/초 | 17.7토큰/초 |
| 21 | 809토큰/초 | 25.0토큰/초 |
| 28 | 969토큰/초 | 38.2토큰/초 |
- 입력 읽기는 올린 층에 거의 비례해 늘었습니다. 482에서 969로, 층을 7개 올릴 때마다 100~160씩 올랐습니다.
- 생성 속도는 앞쪽 14층까지는 거의 늘지 않았습니다. 15.0에서 17.7까지만 올랐고, 21층에서 25.0, 28층에서 38.2로 뒤쪽에서 크게 올랐습니다. 일부만 올리면 속도가 비례해서 오른다고 기대하기 어렵다는 뜻입니다. 그래픽 메모리가 부족해 일부만 올려야 한다면 올릴 수 있는 만큼 최대한 올리는 쪽이 낫습니다.
- 마지막 줄(28층)이 위 2번 표의 99(전부)와 거의 같습니다. 이 모델은 28층이라 99나 28이나 전부를 올린 상태입니다. 생성 속도는 38.2와 45.3으로 달랐는데, 같은 설정의 반복에서도 이 정도 흔들림이 있었습니다(아래 정정 참고).
4. 정정: 처음 측정값이 반복에서 재현되지 않았습니다
이 글의 처음 판은 7B의 -ngl 99 입력 읽기를 496토큰/초로 적었습니다. -ngl 0의 474와 거의 같아서 결론이 "입력 읽기는 그래픽이 별 도움이 안 된다"였습니다. 이를 다시 확인하려고 같은 명령을 세 번 더 돌렸더니 값이 달랐습니다.
| 7B, ngl 99 | 입력 읽기 pp256 | 생성 tg32 |
|---|---|---|
| 처음 측정 | 496 | 37.6 |
| 다시 측정 1 | 983 | 44.0 |
| 다시 측정 2 | 1,001 | 45.2 |
| 다시 측정 3 | 1,017 | 45.3 |
다시 잰 세 번은 서로 비슷했고, 처음 값만 입력 읽기가 절반이었습니다. 처음 측정 때는 Ollama에 gemma4:31b가 올라 있었고, 지금은 qwen3.8:27b가 올라 있습니다. 두 번 모두 유휴 상태였지만, 처음 값이 낮았던 원인은 확인하지 못했습니다. 그래서 표를 새 값으로 고치고 결론도 바꿨습니다. -ngl 0일 때도 입력 읽기가 458로 99(1,017)의 절반 아래였으므로, "7B 입력 읽기는 거의 차이가 없다"는 처음 결론은 틀렸습니다.
이 정정에서 얻는 교훈은 하나입니다. -r 1처럼 한 번만 재면 다른 프로세스나 메모리 상태에 따라 2배까지 달라질 수 있습니다. 결정에 쓸 값은 -r 3 이상으로 재고, 측정 중에 다른 무거운 모델이 올라 있는지 확인합니다.
5. 쓰는 법
| 상황 | 방법 |
|---|---|
| 그래픽 메모리가 충분함 | -ngl 99로 전부 올림 |
| 모델이 그래픽 메모리보다 큼 | -ngl을 낮춰 일부 층만 올리되, 3번 표처럼 속도가 비례해서 오르지 않음을 감안 |
| 그래픽 드라이버 문제를 의심함 | -ngl 0으로 돌려 CPU 쪽 동작을 비교 |
-ngl 0인데도 출력의 backend 열에는 Vulkan이 그대로 적혀 있었습니다. 입력을 한꺼번에 읽는 계산 일부는 -ngl 0이어도 그래픽 쪽이 맡았을 가능성이 있지만 확인하지 않았습니다. "-ngl 0 = 완전한 CPU 전용"이라고 단정할 수 없습니다. 또 이 PC는 CPU와 그래픽이 메모리를 함께 쓰는 구조라서, 별도 그래픽 카드가 있는 PC에서는 결과가 다를 수 있습니다.
더 해 보기: -ngl 0이어도 입력 읽기는 그래픽이 돕습니다
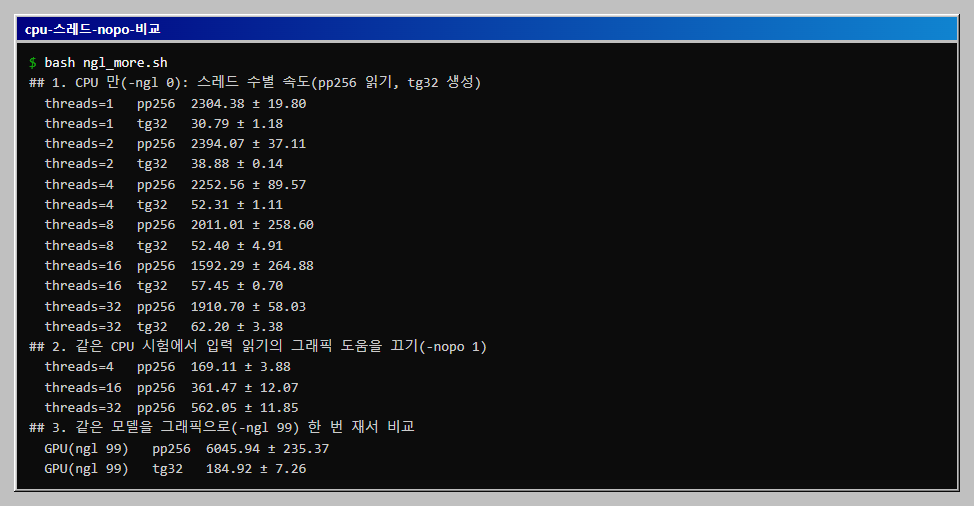
위 표에서 -ngl 0(층을 하나도 그래픽에 올리지 않음)으로 CPU만 쓰게 했는데도 입력 읽기(pp) 속도가 생각보다 높았습니다. 이것이 정말 CPU의 속도인지 확인하려고 1B 모델로 스레드 수(-t)를 바꿔 가며 쟀고, 입력 읽기에서 그래픽이 돕는 동작을 끄는 옵션(-nopo 1, --no-op-offload)도 비교했습니다(ngl_more.sh, 모두 3회 평균).
CPU만 쓸 때, 스레드 수별
| 스레드 | 입력 256토큰 읽기(pp256) | 출력 32토큰 생성(tg32) |
|---|---|---|
| 1 | 2,304 토큰/초 | 30.8 토큰/초 |
| 2 | 2,394 | 38.9 |
| 4 | 2,253 | 52.3 |
| 8 | 2,011 | 52.4 |
| 16 | 1,592 | 57.5 |
| 32 | 1,911 | 62.2 |
- 생성 속도는 스레드가 늘수록 올라갔습니다. 1개에서 31토큰/초, 32개에서 62토큰/초로 두 배가 되었지만, 4개까지가 가장 가파르고(31에서 52) 그 뒤는 완만했습니다. 코어를 늘려도 비례해서 빨라지지 않는 것은 생성이 메모리에서 모델을 읽는 속도에 묶여 있기 때문으로 추정합니다.
- 입력 읽기는 스레드가 늘수록 오히려 느려졌고 숫자도 너무 높았습니다. 스레드 1개로 나온 2,304토큰/초는 CPU 한 코어의 속도라고 보기 어렵습니다.
그래픽의 도움을 끄면
-nopo 1을 주면 입력을 읽을 때 그래픽으로 넘기는 동작이 꺼집니다.
| 스레드 | 입력 256토큰 읽기, 그래픽 도움 있음(기본) | 그래픽 도움 끔(-nopo 1) |
|---|---|---|
| 4 | 2,253 | 169 |
| 16 | 1,592 | 361 |
| 32 | 1,911 | 562 |
도움을 끄자 입력 읽기는 13분의 1(4스레드, 2,253에서 169)에서 3.4분의 1(32스레드, 1,911에서 562)로 떨어졌고, 스레드가 늘수록 올라가는 진짜 CPU다운 모양이 되었습니다. 즉 -ngl 0이라는 설정은 "모델의 층을 그래픽 메모리에 올리지 않는다"는 뜻일 뿐이고, 긴 입력을 한꺼번에 읽는 계산은 그래픽이 맡을 수 있습니다. 이 PC의 Vulkan 빌드에서 관찰한 결과이며, 그래픽 도움이 어떤 계산에 쓰이는지 내부는 확인하지 않았습니다.
그래픽 전부(-ngl 99)와 비교
| 방식 | 입력 256토큰 읽기 | 출력 32토큰 생성 |
|---|---|---|
| CPU만, 그래픽 도움 끔, 32스레드 | 562 토큰/초 | 약 62 토큰/초(위 표) |
CPU만(-ngl 0), 기본 |
약 1,900 토큰/초 | 약 62 토큰/초 |
그래픽 전부(-ngl 99) |
6,046 토큰/초 | 185 토큰/초 |
그래픽을 전부 쓰는 쪽이 생성에서 CPU의 약 3배(185 대 62), 입력 읽기에서 순수 CPU의 10배 넘게(6,046 대 562) 빨랐습니다. 이 PC처럼 내장 그래픽이 메모리를 공유하는 경우에도 그래픽 쪽이 훨씬 빠르다는 점은 앞의 결과와 같습니다.
정리하면 "CPU로만 돌려 본다"며 -ngl 0만 주고 측정한 입력 읽기 속도는 CPU 속도가 아닙니다. CPU 성능을 보려면 -nopo 1도 함께 주거나 생성 속도(tg)를 봅니다. 3회 평균으로 잰 값이지만 숫자는 이 PC에서 이 시점의 값입니다.
ngl_more.sh는 아래와 같습니다.
#!/usr/bin/env bash
# llama-bench 로 CPU 로만 돌릴 때(-ngl 0) 스레드 수(-t)에 따라 속도가 어떻게 달라지는지, 1B 모델로 잰다. 모두 3회 평균.
# 준비: llama.cpp Vulkan 빌드(llama-bench.exe), Llama-3.2-1B GGUF. 이 PC 는 논리 코어 32개.
# -nopo(--no-op-offload)는 -ngl 0 이어도 입력을 읽을 때 그래픽을 쓰는 동작을 끈다.
# 실행(Git Bash): bash ngl_more.sh   (약 2분)
LLAMA=/c/llama.cpp
M1=/c/models/Llama-3.2-1B-Instruct-Q4_K_M.gguf
cd "$LLAMA" || exit 1

# 표의 뒤쪽 두 열(시험 이름, 속도)과 7번째 열(스레드 수)만 한 줄로 보여 준다
show() {
  tr -d '\r' | awk -F'|' '$2 ~ /llama|qwen/ {t=$(NF-2); v=$(NF-1); gsub(/^ +| +$/, "", $7); gsub(/^ +| +$/, "", t); gsub(/^ +| +$/, "", v); printf "  threads=%-3s %-6s %s\n", $7, t, v}'
}

echo "## 1. CPU 만(-ngl 0): 스레드 수별 속도(pp256 읽기, tg32 생성)"
./llama-bench.exe -m "$M1" -ngl 0 -t 1,2,4,8,16,32 -p 256 -n 32 -r 3 2>/dev/null | show

echo "## 2. 같은 CPU 시험에서 입력 읽기의 그래픽 도움을 끄기(-nopo 1)"
./llama-bench.exe -m "$M1" -ngl 0 -nopo 1 -t 4,16,32 -p 256 -n 0 -r 3 2>/dev/null | show

echo "## 3. 같은 모델을 그래픽으로(-ngl 99) 한 번 재서 비교"
./llama-bench.exe -m "$M1" -ngl 99 -p 256 -n 32 -r 3 2>/dev/null | tr -d '\r' | awk -F'|' '$2 ~ /llama/ {t=$(NF-2); v=$(NF-1); gsub(/^ +| +$/, "", t); gsub(/^ +| +$/, "", v); printf "  GPU(ngl 99)   %-6s %s\n", t, v}'
전체 코드
아래 파일 하나로 위 측정을 모두 다시 할 수 있습니다. 그대로 복사해 ngl_bench.sh로 저장하고 Git Bash에서 bash ngl_bench.sh로 실행합니다. 맨 위 세 경로(LLAMA, M1, M7)만 내 PC에 맞게 고칩니다. 실행에 약 3분이 걸렸습니다.
# ngl_bench.sh
#!/usr/bin/env bash
# llama-bench 로 -ngl(그래픽에 올릴 층 수)을 바꿔 가며 입력 읽기(pp)와 생성(tg) 속도를 잰다.
# 준비: llama.cpp Vulkan 빌드(llama-bench.exe)와 GGUF 모델 두 개.
# 실행(Git Bash): bash ngl_bench.sh
LLAMA=/c/llama.cpp
M1=/c/models/Llama-3.2-1B-Instruct-Q4_K_M.gguf
M7=/c/models/Qwen2.5-7B-Instruct-Q4_K_M.gguf

cd "$LLAMA" || exit 1

# llama-bench 의 표에서 모델, ngl, 테스트, 속도 열만 한 줄로 줄여 보여 준다.
bench() {
  ./llama-bench.exe "$@" 2>/dev/null | tr -d '\r' |
    awk -F'|' '$2 ~ /llama|qwen/ {gsub(/^ +| +$/, "", $2); gsub(/ +/, "", $7); gsub(/^ +/, "", $8); printf "%-24s ngl=%-3d %-6s %s\n", $2, $6, $7, $8}'
}

echo "## 1. 두 값 비교: 99(전부 그래픽)와 0(하나도 안 올림)"
bench -m "$M1" -m "$M7" -ngl 99 -p 256 -n 32 -r 1
bench -m "$M1" -m "$M7" -ngl 0  -p 256 -n 32 -r 1

echo "## 2. 7B 중간 값: 28층 모델에서 일부만 올리기"
bench -m "$M7" -ngl 0,7,14,21,28 -p 256 -n 32 -r 1
자주 막히는 곳
| 증상 | 원인과 해결 |
|---|---|
-ngl 99로 했는데 속도가 안 남 |
Vulkan 장치를 못 찾았을 가능성. 실행 첫 줄의 Found 1 Vulkan devices 확인 |
| 결과가 실행마다 다름 | -r 1은 한 번만 측정. -r 3 이상으로 평균 계산 |
| 앞선 글의 숫자와 다름 | 앞선 글은 입력 512토큰·생성 64토큰, 이 글은 256·32토큰으로 측정. 측정 조건이 다르면 직접 비교하지 않음 |
| 스크립트가 아무것도 출력하지 않음 | /c/llama.cpp와 /c/models 경로는 이 PC 기준. 파일 위쪽의 세 경로 변수를 내 환경에 맞게 수정 |
확인 범위
- 해 본 것: 29일에 ngl_more.sh로 CPU 스레드 수별 속도, 그래픽 도움을 끈 입력 읽기(-nopo 1), 그래픽 전부와의 비교를 3회 평균으로 쟀습니다. 앞의 확인 내용은 다음과 같습니다. 2026-10-28과 29일, Windows 11 · llama.cpp 빌드 9050(Vulkan)에서 조건마다 측정했습니다. 29일에는 전체 스크립트를 세 번 실행했고(7B ngl 99는 처음 측정까지 네 값), 중간 값 5개는 마지막 실행의 값입니다. 측정 중 같은 PC에 Ollama 모델 하나(처음
gemma4:31b, 이후qwen3.8:27b)가 유휴 상태로 올라 있었습니다. - 해 보지 않은 것: 7B 모델의 스레드 수별 속도, 그래픽 도움이 쓰이는 계산의 내부 확인, 2번과 3번 표의
-r 3이상 반복 평균, CPU 전용 빌드, 다른 양자화, CUDA와 Metal, 처음 측정이 낮았던 원인 규명. - 읽을 때 주의: 2번과 3번 표는 각 값을 한 번씩 잰 것이라 몇 퍼센트 차이는 의미가 없습니다. 입력 읽기 속도는 특히 흔들렸습니다.
이 글은 Ollama와 로컬 LLM 실습 로드맵의 한 단계입니다.
이 글의 다음 단계
- llama.cpp와 GGUF 파일로 내 PC 속도 재기: llama-bench로 1B와 7B 비교Ollama 없이 llama.cpp의 llama-bench로 GGUF 모델을 직접 재 봅니다. 내장 그래픽의 Vulkan으로 1B와 7B 모델의 입력 읽기 속도와 생성 속도를 3회 평균으로 비교하고, 파일 크기에서 양자화 비트 수를 계산하는 전체 스크립트를 실행합니다.
- 작은 모델의 출력 형식을 고정하기: llama-server의 JSON 스키마와 GBNF 문법프롬프트로 JSON을 부탁하면 1B 모델은 열두 번 중 열 번만 읽히고 한 번도 스키마에 맞지 않았습니다. llama-server의 json_schema와 GBNF 문법으로 출력을 제한하면 어떻게 달라지는지, 형식은 지켜져도 내용의 정확도는 그대로인 점까지 모델 두 개로 비교합니다.
이 내용을 팀 교육으로 진행하고 싶으신가요?
인원, 수준, 일정에 맞춰 실습 환경까지 준비해 진행합니다. 대상과 기간을 알려 주시면 구성을 제안해 드립니다.
교육 문의하기메일로 보내실 수도 있습니다: fankh111@gmail.com