로컬 모델과 달리 클라우드 AI 서비스는 질문이 인터넷을 거쳐 서비스 회사 서버에서 처리됩니다. 설치와 메모리 걱정이 없는 대신 API 키가 필요하고, 쓴 양만큼 비용이 생길 수 있습니다. 이 글은 Google의 Gemini API를 파이썬에서 처음 부르는 가장 짧은 길을 따라갑니다. 키를 코드에 적지 않고 환경 변수로 보관하는 방법과, 오류가 났을 때 무엇을 보는지까지 다룹니다.
준비물
| 항목 | 확인한 값 |
|---|---|
| Python | 3.12.10 (Windows 11) |
| 라이브러리 | google-genai 2.24.0 |
| 모델 | gemini-2.5-flash-lite |
| API 키 | Google AI Studio에서 발급한 키 (사용자 환경 변수 GEMINI_API_KEY로 보관) |
키 발급 화면과 무료 사용 한도, 요금은 이 글에서 확인하지 않았습니다. 서비스 쪽 정책은 자주 바뀌므로 발급 화면의 안내를 따릅니다.
1. 설치와 키 보관
pip install google-genai
API 키는 비밀번호와 같습니다. 코드나 저장소에 적으면 유출되어 다른 사람이 내 비용으로 호출할 수 있습니다. 환경 변수에 넣어 두고 코드에서는 읽기만 합니다. 이 PC에서는 GEMINI_API_KEY가 사용자 환경 변수로 등록되어 있었고, 라이브러리가 이 이름을 자동으로 읽었습니다.
from google import genai

c = genai.Client()   # GEMINI_API_KEY 환경 변수를 자동으로 읽는다
r = c.models.generate_content(model="gemini-2.5-flash-lite", contents="OK라고만 답하세요.")
print(r.text.strip())
# 기대 출력
OK
키 값을 화면에 찍거나 로그에 남기지 않습니다. 환경 변수를 새로 등록한 뒤에는 터미널을 다시 열어야 읽힙니다. 등록 명령(setx)은 이 글에서 실행하지 않았습니다.
2. 첫 응답과 토큰 사용량
r = c.models.generate_content(model="gemini-2.5-flash-lite",
                              contents="한국어로 한 문장만 자기소개 해 주세요.")
print(r.text.strip())
u = r.usage_metadata
print(u.prompt_token_count, u.candidates_token_count, u.total_token_count)
# 기대 출력(이 PC)
안녕하세요, 저는 여러분의 질문에 답변하고 정보를 제공하는 데 도움을 드릴 수 있는 대규모 언어 모델입니다.
13 25 38
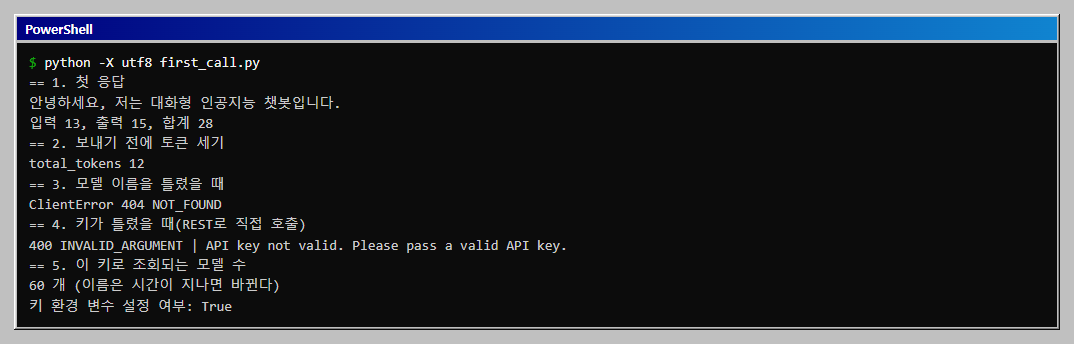
usage_metadata에 입력 토큰(13), 출력 토큰(25), 합계(38)가 나옵니다. 클라우드 서비스는 보통 이 토큰 수를 기준으로 비용을 계산하므로, 로컬 모델과 달리 호출마다 이 값을 기록해 두면 쓴 양을 추적할 수 있습니다. 단가는 이 글에서 확인하지 않았습니다.
3. 보내기 전에 토큰 세기
ct = c.models.count_tokens(model="gemini-2.5-flash-lite", contents="한국어로 토큰을 세어 봅니다.")
print(ct.total_tokens)
# 기대 출력
12
긴 문서를 보내기 전에 크기를 가늠할 때 씁니다. 이 호출에 비용이 드는지는 확인하지 않았습니다.
4. 오류 읽기
모델 이름을 틀리게 부르면 이런 오류가 납니다.
c.models.generate_content(model="gemini-no-such-model", contents="hi")
# 기대 출력(일부)
ClientError 404 NOT_FOUND ... models/gemini-no-such-model is not found for API version v1beta ...
키가 틀리면 HTTP 400이 돌아옵니다. 라이브러리 대신 REST 주소를 직접 불러 확인했습니다.
# 기대 출력
400 INVALID_ARGUMENT | API key not valid. Please pass a valid API key.
| 오류 | 의미 | 먼저 볼 것 |
|---|---|---|
| 404 NOT_FOUND | 모델 이름이 없음 | 모델 목록에서 이름 확인 |
400 INVALID_ARGUMENT, API key not valid |
키가 틀림 | 환경 변수 값과 터미널 재시작 |
사용 가능한 모델 이름은 c.models.list()로 볼 수 있습니다. 이 키로는 모델 60개가 조회됐고, 이름은 시간이 지나면 바뀌므로 글의 모델명을 그대로 믿지 않고 목록에서 확인합니다.
더 해 보기: 언어별 토큰 수, 출력 제한, 반복 결과, 응답 시간, 생각 토큰
첫 호출 뒤에 가장 먼저 궁금한 것은 "이 글을 보내면 토큰이 얼마나 들고, 답은 어떻게 끝나고, 같은 질문에 같은 답이 나오는가"입니다. 앞의 코드에 이어 gemini_more.py로 다섯 가지를 확인했습니다. 호출은 30번 안팎이며 같은 모델(gemini-2.5-flash-lite)을 썼습니다.
언어별 토큰 수
count_tokens로 보내기 전에 토큰 수를 셀 수 있습니다. 같은 뜻의 글을 한국어와 영어로 비교했습니다.
| 종류 | 글자 수 | 토큰 수 | 글자당 토큰 비율(글자/토큰) |
|---|---|---|---|
| 한국어 문장 | 34 | 18 | 1.89 |
| 영어 문장 | 73 | 19 | 3.84 |
| 한국어 용어 | 27 | 17 | 1.59 |
| 영어 용어 | 78 | 11 | 7.09 |
| 파이썬 코드 | 49 | 24 | 2.04 |
| 숫자 나열 | 55 | 56 | 0.98 |
같은 뜻이라도 한국어 문장은 18토큰, 영어는 19토큰으로 비슷했지만, 글자 수로는 영어가 두 배 넘게 깁니다. 토큰 하나가 한국어에서는 글자 1.6에서 1.9개, 영어에서는 3.8에서 7개에 해당했습니다. 글자 수가 같다면 한국어의 토큰 수가 영어보다 두 배 가까이 많게 나올 수 있다는 뜻입니다. 비용과 제한은 글자가 아니라 토큰으로 셉니다. 숫자 나열은 글자 하나가 토큰 하나로 가장 비쌌습니다(0.98). 긴 표나 숫자 로그를 통째로 보낼 때 입력이 생각보다 빨리 커집니다. 이 숫자는 한 번씩만 센 값이고 문장에 따라 달라집니다.
출력 길이 제한과 종료 이유
max_output_tokens를 주면 답이 그 길이에서 잘립니다. 답이 어떻게 끝났는지는 finish_reason으로 압니다.
| 한도 | 종료 이유 | 출력 토큰 | 끝 부분 |
|---|---|---|---|
| 12 | MAX_TOKENS |
12 | 문장 중간에서 끊김 |
| 1500 | STOP |
519 | ...더 커지고 있습니다.로 자연스럽게 끝남 |
MAX_TOKENS는 "한도에 걸려서 끊겼다"는 뜻이고, STOP은 모델이 스스로 끝냈다는 뜻입니다. 프로그램이 답을 JSON으로 읽는다면 STOP이 아닌 종료 이유는 불완전한 답으로 다루어야 합니다. 한도를 처음 400으로 두고 시험했을 때도 MAX_TOKENS가 나왔습니다. 한 질문에 다섯 가지를 설명하게 하면 400토큰으로는 모자라서였습니다. 한도를 낮게 두면 답이 잘리는 것이 흔하므로, 필요한 길이를 먼저 재어 보고 여유 있게 줍니다.
같은 질문을 반복하면
"동물 하나를 골라 이름만 한 단어로 답하세요"를 다섯 번씩 보냈습니다.
| temperature | 서로 다른 답 | 답 목록 |
|---|---|---|
| 0.0 | 1가지 | 고양이 다섯 번 |
| 1.5 | 3가지 | 고양이, 고양이, 개, 호랑이, 호랑이 (다른 실행에서는 코끼리, 강아지, 고양이가 섞여 나옴) |
temperature가 0이면 다섯 번 모두 같았고 1.5에서는 매번 다른 답이 섞였습니다. 다만 0이어도 항상 같다는 보장은 없습니다. 서버 쪽 계산 때문에 드물게 달라질 수 있다고 알려져 있고, 이 글에서는 다섯 번만 확인했습니다. 시험이나 채점처럼 같은 결과가 필요한 일에는 0을 주고, 여러 가지 문구가 필요한 일에는 높입니다.
응답 시간
같은 짧은 질문을 다섯 번 보내자 최소 0.65초, 중앙값 0.69초, 최대 0.75초로 거의 일정했습니다. 한 문장짜리 답이어서 그렇습니다. 답이 길어지면 응답 시간도 출력 토큰에 비례해 늘어나므로, 시간이 걱정되면 출력 길이를 먼저 줄입니다. 이 값은 이 PC의 네트워크와 이 시간대의 값입니다.
생각 토큰(thinking)
일부 모델은 답하기 전에 "생각"을 하며 이 생각도 토큰으로 셉니다(출력 요금에 포함될 수 있음). thinking_budget으로 조절합니다. 곱셈 문제로 비교했습니다.
| 설정 | 생각 토큰 | 출력 토큰 | 답 |
|---|---|---|---|
| 기본 | 없음(None) |
68 | 17 곱하기 23은 391 |
thinking_budget=0 |
없음(None) |
32 | 391 |
thinking_budget=1024 |
327 | 37 | 391 |
세 설정 모두 정답(391)이었습니다. 기본 설정은 이 모델에서 생각을 쓰지 않았고(None), 예산을 1024로 주었을 때만 327토큰을 썼습니다. 쉬운 문제에 생각을 켜면 답은 같은데 토큰만 늘었습니다. 어려운 추론에는 도움이 될 수 있지만 이 글에서는 어려운 문제를 시험하지 않았습니다. 출력 토큰이 기본에서 68, 끔에서 32로 다른 것은 같은 정답이라도 풀이를 길게 쓰느냐의 차이였습니다.
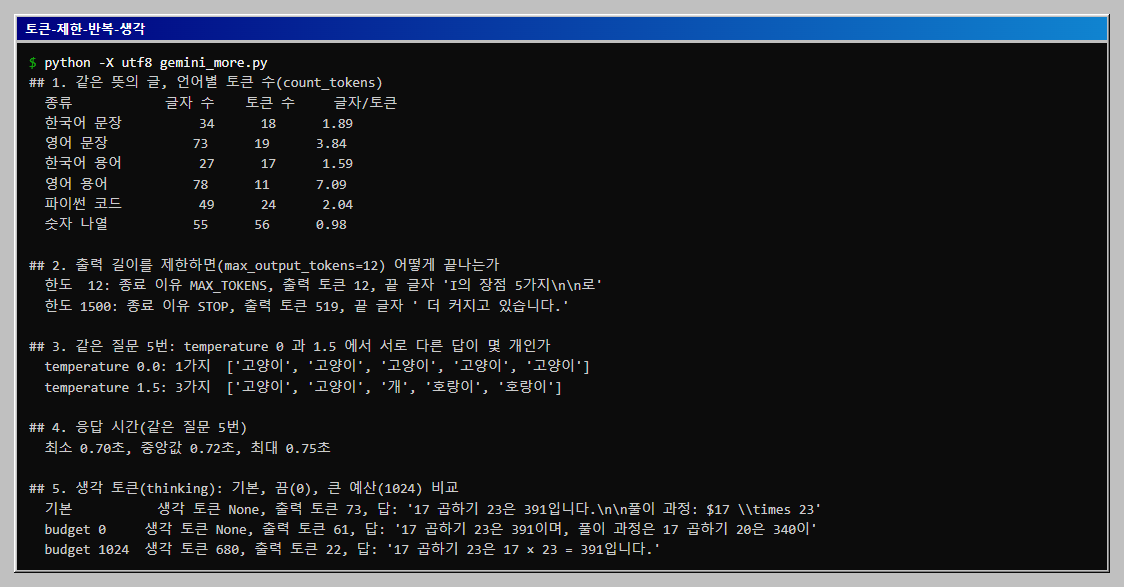
gemini_more.py는 아래와 같습니다. 호출을 30번 안팎 보내므로 무료 한도가 작은 키에서는 중간에 429(한도 초과) 오류가 날 수 있습니다.
"""Gemini API 심화: 언어별 토큰 수, 출력 길이 제한과 종료 이유, 같은 질문의 반복 결과, 응답 시간, 생각 토큰.

준비: pip install google-genai, 환경 변수 GEMINI_API_KEY (코드에 적지 않는다)
주의: 호출을 약 30번 보낸다. 무료 한도가 작은 키에서는 중간에 429 오류가 날 수 있다.
실행: python -X utf8 gemini_more.py   (약 1분)
"""
import statistics
import time

from google import genai
from google.genai import types

MODEL = "gemini-2.5-flash-lite"
c = genai.Client()

print("## 1. 같은 뜻의 글, 언어별 토큰 수(count_tokens)")
samples = {
    "한국어 문장": "오늘은 날씨가 좋아서 공원에서 산책을 하며 사진을 찍었습니다.",
    "영어 문장": "The weather was nice today, so I took a walk in the park and took photos.",
    "한국어 용어": "취약점 점검과 침투 시험의 차이를 설명해 주세요.",
    "영어 용어": "Explain the difference between vulnerability scanning and penetration testing.",
    "파이썬 코드": "def add(a, b):\n    return a + b\n\nprint(add(1, 2))",
    "숫자 나열": "1234567890 " * 5,
}
print(f"  {'종류':<10}{'글자 수':>8}{'토큰 수':>8}{'글자/토큰':>10}")
for name, text in samples.items():
    n = c.models.count_tokens(model=MODEL, contents=text).total_tokens
    print(f"  {name:<10}{len(text):>8}{n:>8}{len(text) / n:>10.2f}")

print("\n## 2. 출력 길이를 제한하면(max_output_tokens=12) 어떻게 끝나는가")
for limit in (12, 1500):
    r = c.models.generate_content(model=MODEL, contents="한국어로 로컬 AI의 장점을 다섯 가지 설명해 주세요.",
                                  config=types.GenerateContentConfig(max_output_tokens=limit))
    fr = r.candidates[0].finish_reason
    print(f"  한도 {limit:>3}: 종료 이유 {getattr(fr, 'name', fr)}, 출력 토큰 {r.usage_metadata.candidates_token_count}, 끝 글자 {r.text.strip()[-12:]!r}")

print("\n## 3. 같은 질문 5번: temperature 0 과 1.5 에서 서로 다른 답이 몇 개인가")
for temp in (0.0, 1.5):
    outs = []
    for _ in range(5):
        r = c.models.generate_content(model=MODEL, contents="동물 하나를 골라 이름만 한 단어로 답하세요.",
                                      config=types.GenerateContentConfig(temperature=temp))
        outs.append(r.text.strip())
    print(f"  temperature {temp}: {len(set(outs))}가지  {outs}")

print("\n## 4. 응답 시간(같은 질문 5번)")
ts = []
for _ in range(5):
    t = time.time()
    c.models.generate_content(model=MODEL, contents="한 문장으로 인사해 주세요.")
    ts.append(time.time() - t)
print(f"  최소 {min(ts):.2f}초, 중앙값 {statistics.median(ts):.2f}초, 최대 {max(ts):.2f}초")

print("\n## 5. 생각 토큰(thinking): 기본, 끔(0), 큰 예산(1024) 비교")
q = "17 곱하기 23은 얼마인가요? 풀이 과정도 한 줄로 쓰세요."
for label, cfg in (("기본", None), ("budget 0", types.ThinkingConfig(thinking_budget=0)),
                   ("budget 1024", types.ThinkingConfig(thinking_budget=1024))):
    conf = types.GenerateContentConfig(thinking_config=cfg) if cfg else None
    r = c.models.generate_content(model=MODEL, contents=q, config=conf)
    u = r.usage_metadata
    print(f"  {label:<12} 생각 토큰 {u.thoughts_token_count}, 출력 토큰 {u.candidates_token_count}, 답: {r.text.strip()[:40]!r}")
전체 코드
아래 파일 하나로 이 글의 모든 실험(응답, 토큰, 토큰 세기, 두 가지 오류, 모델 수)을 한 번에 돌릴 수 있습니다. 그대로 복사해 first_call.py로 저장하고 python -X utf8 first_call.py로 실행합니다. 같은 파일을 이 글의 내려받기 목록에서도 받을 수 있습니다.
# first_call.py
"""Gemini API 첫 호출: 응답, 토큰 사용량, 토큰 세기, 오류 두 가지를 한 번에 확인한다.

준비:
  pip install google-genai requests
  환경 변수 GEMINI_API_KEY 에 키를 넣어 둔다(코드에 적지 않는다).
실행:
  python -X utf8 first_call.py
"""
import os
import requests
from google import genai
from google.genai import errors

MODEL = "gemini-2.5-flash-lite"
c = genai.Client()  # GEMINI_API_KEY 환경 변수를 자동으로 읽는다

print("== 1. 첫 응답")
r = c.models.generate_content(model=MODEL, contents="한국어로 한 문장만 자기소개 해 주세요.")
print(r.text.strip())
u = r.usage_metadata
print("입력 %s, 출력 %s, 합계 %s" % (u.prompt_token_count, u.candidates_token_count, u.total_token_count))

print("== 2. 보내기 전에 토큰 세기")
ct = c.models.count_tokens(model=MODEL, contents="한국어로 토큰을 세어 봅니다.")
print("total_tokens", ct.total_tokens)

print("== 3. 모델 이름을 틀렸을 때")
try:
    c.models.generate_content(model="gemini-no-such-model", contents="hi")
except errors.ClientError as e:
    print(type(e).__name__, e.code, e.status)

print("== 4. 키가 틀렸을 때(REST로 직접 호출)")
resp = requests.post(
    "https://generativelanguage.googleapis.com/v1beta/models/%s:generateContent" % MODEL,
    headers={"x-goog-api-key": "not-a-real-key", "content-type": "application/json"},
    json={"contents": [{"parts": [{"text": "hi"}]}]}, timeout=30)
err = resp.json().get("error", {})
print(resp.status_code, err.get("status"), "|", err.get("message", "")[:60])

print("== 5. 이 키로 조회되는 모델 수")
print(sum(1 for _ in c.models.list()), "개 (이름은 시간이 지나면 바뀐다)")
print("키 환경 변수 설정 여부:", bool(os.environ.get("GEMINI_API_KEY")))
자주 막히는 곳
| 증상 | 원인과 해결 |
|---|---|
KeyError: GEMINI_API_KEY 또는 키 없음 오류 |
환경 변수가 이 터미널에 없습니다. 터미널을 다시 엽니다 |
| 한글 출력이 깨짐 | python -X utf8 파일.py로 실행합니다 |
| 함수 자동 호출(AFC)을 권하지 않는다는 경고가 나옴 | 일부 호출에서 라이브러리가 찍는 안내 문구였습니다. 응답에는 영향이 없었습니다 |
| 오류 메시지에 키가 보임 | 로그를 공유하기 전에 키가 들어 있지 않은지 확인합니다 |
확인 범위
- 해 본 것: 29일에 gemini_more.py로 언어별 토큰 수, 출력 제한의 종료 이유, 같은 질문의 반복 결과, 응답 시간, 생각 토큰을 확인했습니다. 앞의 확인 내용은 다음과 같습니다. 2026-10-28과 29일, Windows 11 · Python 3.12.10 ·
google-genai2.24.0 ·gemini-2.5-flash-lite로 위 코드를 실행했고, 29일에 위 전체 코드를 한 파일로 묶어 다시 실행했습니다. 같은 질문이어도 답과 토큰 수는 실행마다 달랐습니다(출력 토큰 25와 15). - 해 보지 않은 것: 어려운 추론 문제에서의 생각 토큰 효과, 요금 계산, 무료 한도, 사용량 제한(429) 오류와 재시도, 키 발급과 제한 설정, 다른 모델, Linux와 macOS.
- 읽을 때 주의: 시스템 지시, JSON 출력, 스트리밍은 이 글에서 다루지 않고 이어지는 글에서 다룹니다.
이 글의 다음 단계
- 파이썬에서 로컬 Ollama API 호출하기: 응답 받기, JSON 형식 고정, 스트리밍requests만으로 내 PC의 Ollama를 호출합니다. 한 번에 받기, 옵션 넘기기, JSON 스키마로 출력 형식 고정하기, 글자가 나오는 대로 받는 스트리밍을 실행해 결과를 확인합니다. 한글이 깨지는 Windows 함정도 함께 정리합니다.
- 작은 모델의 출력 형식을 고정하기: llama-server의 JSON 스키마와 GBNF 문법프롬프트로 JSON을 부탁하면 1B 모델은 열두 번 중 열 번만 읽히고 한 번도 스키마에 맞지 않았습니다. llama-server의 json_schema와 GBNF 문법으로 출력을 제한하면 어떻게 달라지는지, 형식은 지켜져도 내용의 정확도는 그대로인 점까지 모델 두 개로 비교합니다.
이 내용을 팀 교육으로 진행하고 싶으신가요?
인원, 수준, 일정에 맞춰 실습 환경까지 준비해 진행합니다. 대상과 기간을 알려 주시면 구성을 제안해 드립니다.
교육 문의하기메일로 보내실 수도 있습니다: fankh111@gmail.com