OpenAI API 형식에 맞춰 짠 프로그램은 주소만 바꾸면 로컬 모델로도 돌릴 수 있습니다. llama.cpp에 들어 있는 llama-server가 그 주소를 열어 줍니다. 이 글에서는 7B 모델 파일(GGUF) 하나를 올려 서버를 띄우고, 같은 서버를 requests와 openai 라이브러리로 부른 뒤 서버를 내립니다.
준비물
| 항목 | 확인한 버전 |
|---|---|
| llama.cpp | 빌드 3980e04d5 (9050), Windows, Vulkan 백엔드 |
| 모델 | Qwen2.5-7B-Instruct-Q4_K_M.gguf (4.36GiB) |
| Python | 3.12.10, requests 2.34.2, openai 3.8.0 |
1. 서버 띄우기
./llama-server.exe -m Qwen2.5-7B-Instruct-Q4_K_M.gguf --host 127.0.0.1 --port 8091 -ngl 99 -c 4096
| 옵션 | 뜻 |
|---|---|
--host 127.0.0.1 |
이 PC 안에서만 접속 허용. 기본값을 믿지 말고 직접 지정 |
--port 8091 |
다른 프로그램이 쓰지 않는 포트 |
-ngl 99 |
모든 층을 그래픽 쪽에 올림 |
-c 4096 |
한 번에 기억하는 길이(토큰) |
모델이 올라오는 데 시간이 걸리므로 준비됐는지 확인합니다.
curl -s localhost:8091/health
# 기대 출력
{"status":"ok"}
로그에는 server is listening on http://127.0.0.1:8091이 찍혔고, netstat에서도 127.0.0.1:8091만 LISTENING이었습니다.
2. requests로 부르기
import requests

r = requests.post("http://127.0.0.1:8091/v1/chat/completions", json={
    "model": "any",
    "messages": [{"role": "user", "content": "한국어로 로컬 AI의 장점을 한 문장으로 말해 주세요."}],
    "max_tokens": 80})
d = r.json()
print(r.status_code)
print(d["choices"][0]["message"]["content"])
print(d["usage"], d["timings"]["predicted_per_second"])
# 기대 출력(이 PC)
200
로컬 AI는 데이터 처리 속도가 빠르고, 프라이버시 보호에 효과적입니다.
{'completion_tokens': 28, 'prompt_tokens': 48, ...} 38.36
응답은 OpenAI와 같은 choices[0].message.content 구조이고, usage에 토큰 수가 들어 있습니다. timings.predicted_per_second는 llama-server가 덧붙이는 항목으로, 이 실행에서는 초당 약 38토큰이었습니다. model 값은 아무 문자열이나 넣어도 동작했습니다. 서버에 모델이 하나뿐이어서 그런 것으로 보이며, 여러 모델을 올렸을 때의 동작은 확인하지 않았습니다. 올라간 모델 이름은 /v1/models에서 확인합니다.
3. openai 라이브러리로 부르기
주소만 바꾸면 기존 코드를 그대로 쓸 수 있습니다. api_key는 필수 입력이라 아무 문자열이나 넣습니다.
from openai import OpenAI

c = OpenAI(base_url="http://127.0.0.1:8091/v1", api_key="none")
r = c.chat.completions.create(model="any", max_tokens=80,
    messages=[{"role": "user", "content": "두 문장으로 자기소개 해 주세요."}])
print(r.choices[0].message.content, r.usage.completion_tokens)

for ch in c.chat.completions.create(model="any", max_tokens=40, stream=True,
        messages=[{"role": "user", "content": "1부터 5까지 세어 주세요."}]):
    print(ch.choices[0].delta.content or "", end="", flush=True)
한 번에 받기와 스트리밍 모두 정상 동작했습니다. 자기소개 답은 48토큰이었고, 모델이 스스로를 Qwen이라고 소개했습니다.
4. 서버 내리기
실습이 끝나면 서버를 끕니다. 포그라운드로 띄웠다면 Ctrl+C, 백그라운드라면 작업 관리자나 taskkill로 해당 프로세스를 종료합니다. 종료 뒤 netstat에서 8091이 사라진 것을 확인했습니다.
전체 코드
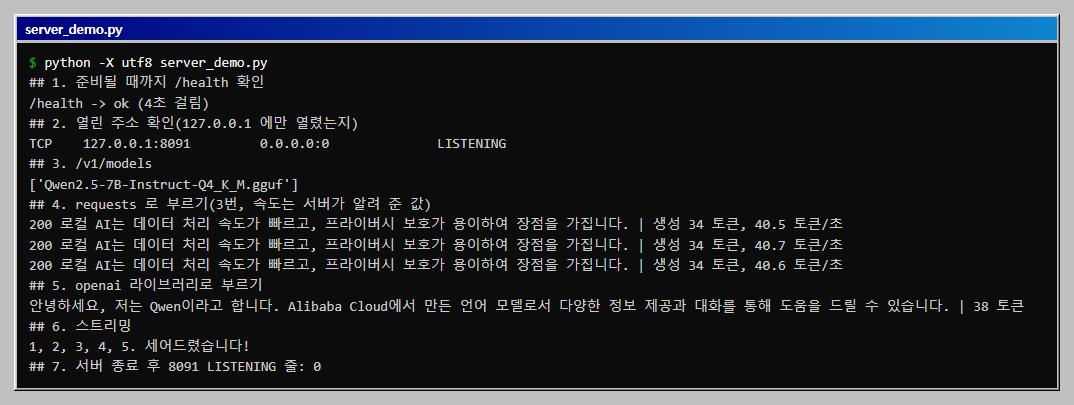
서버 시작, 준비 확인, 열린 주소 확인, 두 가지 호출, 스트리밍, 서버 종료를 한 번에 하는 파일입니다. server_demo.py로 저장하고 SERVER와 MODEL 경로를 내 PC에 맞게 고친 뒤 python -X utf8 server_demo.py로 실행합니다. 이 파일이 띄운 서버만 끝내므로 이미 돌고 있는 다른 서버에는 영향이 없습니다.
"""llama-server 를 127.0.0.1 에만 열고 requests 와 openai 라이브러리로 부른 뒤 서버를 내린다.

준비: llama.cpp Vulkan 빌드(llama-server.exe), GGUF 모델, pip install requests openai
주의: 이 파일이 띄운 서버만 끝낸다. 다른 llama-server 는 건드리지 않는다.
실행: python -X utf8 server_demo.py   (모델 올리는 시간 포함 약 1분)
"""
import subprocess
import time

import requests
from openai import OpenAI

SERVER = r"C:\llama.cpp\llama-server.exe"
MODEL = r"C:\models\Qwen2.5-7B-Instruct-Q4_K_M.gguf"
PORT = 8091
BASE = f"http://127.0.0.1:{PORT}"

proc = subprocess.Popen([SERVER, "-m", MODEL, "--host", "127.0.0.1", "--port", str(PORT),
                         "-ngl", "99", "-c", "4096"],
                        stdout=subprocess.DEVNULL, stderr=subprocess.DEVNULL)
try:
    print("## 1. 준비될 때까지 /health 확인")
    t0 = time.time()
    while True:
        try:
            h = requests.get(f"{BASE}/health", timeout=2).json()
            if h.get("status") == "ok":
                break
        except requests.RequestException:
            pass
        time.sleep(1)
    print(f"/health -> ok ({time.time() - t0:.0f}초 걸림)")

    print("## 2. 열린 주소 확인(127.0.0.1 에만 열렸는지)")
    out = subprocess.run(["netstat", "-an"], capture_output=True, text=True).stdout
    print("\n".join(l.strip() for l in out.splitlines() if f":{PORT} " in l and "LISTENING" in l))

    print("## 3. /v1/models")
    print([m["id"] for m in requests.get(f"{BASE}/v1/models").json()["data"]])

    print("## 4. requests 로 부르기(3번, 속도는 서버가 알려 준 값)")
    for i in range(3):
        r = requests.post(f"{BASE}/v1/chat/completions", json={
            "model": "any",
            "messages": [{"role": "user", "content": "한국어로 로컬 AI의 장점을 한 문장으로 말해 주세요."}],
            "max_tokens": 80, "temperature": 0})
        d = r.json()
        print(r.status_code, d["choices"][0]["message"]["content"],
              "| 생성", d["usage"]["completion_tokens"], "토큰,", round(d["timings"]["predicted_per_second"], 1), "토큰/초")

    print("## 5. openai 라이브러리로 부르기")
    c = OpenAI(base_url=f"{BASE}/v1", api_key="none")
    r = c.chat.completions.create(model="any", max_tokens=80, temperature=0,
                                  messages=[{"role": "user", "content": "두 문장으로 자기소개 해 주세요."}])
    print(r.choices[0].message.content, "|", r.usage.completion_tokens, "토큰")

    print("## 6. 스트리밍")
    for ch in c.chat.completions.create(model="any", max_tokens=40, stream=True, temperature=0,
                                        messages=[{"role": "user", "content": "1부터 5까지 세어 주세요."}]):
        print(ch.choices[0].delta.content or "", end="", flush=True)
    print()
finally:
    proc.terminate()
    proc.wait(timeout=30)
    time.sleep(1)
    out = subprocess.run(["netstat", "-an"], capture_output=True, text=True).stdout
    # 접속이 끝난 연결(TIME_WAIT)은 한동안 남으므로 LISTENING 만 센다
    left = [l for l in out.splitlines() if f":{PORT} " in l and "LISTENING" in l]
    print("## 7. 서버 종료 후 8091 LISTENING 줄:", len(left))
temperature를 0으로 두면 같은 질문에 같은 답이 나옵니다. 위 화면에서 세 번 모두 같은 문장과 34토큰이 나온 이유입니다. 속도는 39.4에서 40.1토큰/초로 거의 같았습니다.
자주 막히는 곳
| 증상 | 원인과 해결 |
|---|---|
/health가 바로 안 됩니다 |
모델을 올리는 중입니다. 몇 초에서 수십 초 뒤에 다시 부릅니다 |
| 포트가 이미 사용 중이라고 나옵니다 | netstat -ano로 쓰는 프로세스를 찾아 다른 포트를 고릅니다 |
openai 라이브러리가 키를 요구합니다 |
api_key에 임의 문자열을 넣습니다 |
| 한글 출력이 깨집니다 | python -X utf8 파일.py로 실행합니다 |
이어서 해 볼 것
- 여러 모델 전환: 서버 하나에 모델 여러 개를 두고
model값으로 고르는 방식은 시험하지 않았습니다. - 외부 접속:
--host 0.0.0.0으로 열면 같은 네트워크의 누구나 접속할 수 있습니다. 인증 없이 열지 않는 편이 좋고, 이 글에서는 열어 보지 않았습니다.
확인 범위
- 해 본 것: 2026-10-28, Windows 11 · llama.cpp 빌드 9050에서 서버 시작,
/health,/v1/chat/completions,/v1/models,openai라이브러리 호출과 스트리밍, 서버 종료를 실행했습니다. 29일에 전체 스크립트로 같은 순서를 다시 실행했습니다(준비 4초, 같은 질문 세 번 39~40토큰/초). - 해 보지 않은 것: Linux와 macOS, CUDA 빌드, 도구 호출과 이미지 입력.
- 읽을 때 주의: 28일 값(38토큰/초)은 한 번만 잰 값이고, 29일 값은 세 번 잰 값입니다. 서버를 띄운 시간과 속도는 이 PC에서만 의미가 있습니다.
이 글은 Ollama와 로컬 LLM 실습 로드맵의 한 단계입니다.
이 글의 다음 단계
- 작은 모델의 출력 형식을 고정하기: llama-server의 JSON 스키마와 GBNF 문법프롬프트로 JSON을 부탁하면 1B 모델은 열두 번 중 열 번만 읽히고 한 번도 스키마에 맞지 않았습니다. llama-server의 json_schema와 GBNF 문법으로 출력을 제한하면 어떻게 달라지는지, 형식은 지켜져도 내용의 정확도는 그대로인 점까지 모델 두 개로 비교합니다.
- llama.cpp와 GGUF 파일로 내 PC 속도 재기: llama-bench로 1B와 7B 비교Ollama 없이 llama.cpp의 llama-bench로 GGUF 모델을 직접 재 봅니다. 내장 그래픽의 Vulkan으로 1B와 7B 모델의 입력 읽기 속도와 생성 속도를 3회 평균으로 비교하고, 파일 크기에서 양자화 비트 수를 계산하는 전체 스크립트를 실행합니다.
이 내용을 팀 교육으로 진행하고 싶으신가요?
인원, 수준, 일정에 맞춰 실습 환경까지 준비해 진행합니다. 대상과 기간을 알려 주시면 구성을 제안해 드립니다.
교육 문의하기메일로 보내실 수도 있습니다: fankh111@gmail.com