Ollama는 내부에서 llama.cpp 계열 엔진을 쓰는 편리한 포장입니다. llama.cpp를 직접 쓰면 모델 파일(GGUF)을 내가 고르고, 같은 조건에서 속도를 정확히 잴 수 있습니다. 이 글은 llama.cpp에 들어 있는 llama-bench로 내 PC의 속도를 재고 결과를 읽는 법을 정리합니다.
준비물
| 항목 | 확인한 값 |
|---|---|
| llama.cpp | 빌드 3980e04d5 (9050), Windows용 미리 빌드 파일, Vulkan 백엔드 |
| 그래픽 | AMD Radeon 8060S (내장, 메모리 공유), 드라이버가 Vulkan 장치로 인식 |
| 모델(GGUF) | Llama-3.2-1B-Instruct-Q4_K_M.gguf, Qwen2.5-7B-Instruct-Q4_K_M.gguf |
GGUF는 llama.cpp가 읽는 모델 파일 형식이고, 파일 이름의 Q4_K_M은 가중치를 4비트 안팎으로 줄인(양자화) 방식입니다. 모델은 Hugging Face 같은 곳에서 내려받습니다. 이 글은 이미 PC에 있던 파일로 실행했으므로 내려받는 과정은 다루지 않습니다.
1. 측정 실행
./llama-bench.exe -m Llama-3.2-1B-Instruct-Q4_K_M.gguf -m Qwen2.5-7B-Instruct-Q4_K_M.gguf -p 512 -n 64 -r 3
| 옵션 | 뜻 |
|---|---|
-m |
잴 모델. 여러 번 쓰면 차례로 측정 |
-p 512 |
입력 512토큰을 읽는 속도(프롬프트 처리) 측정 |
-n 64 |
64토큰을 만드는 속도(생성) 측정 |
-r 3 |
반복 횟수. 3번 재서 평균과 표준편차(±) 표시 |
실행하면 먼저 그래픽 장치를 찾았다는 줄이 나옵니다.
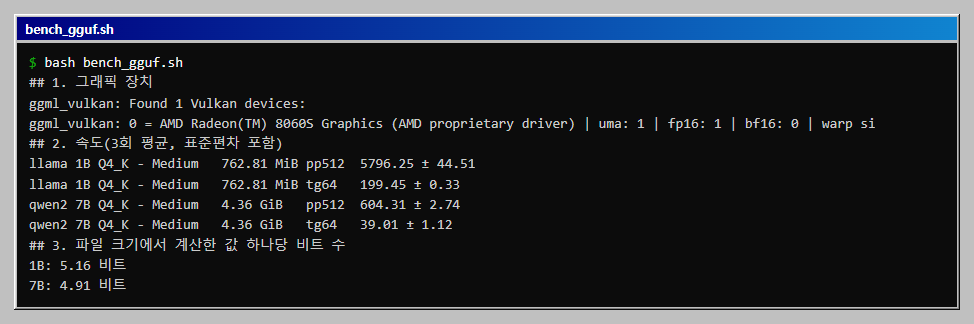
ggml_vulkan: Found 1 Vulkan devices:
ggml_vulkan: 0 = AMD Radeon(TM) 8060S Graphics (AMD proprietary driver) | uma: 1 | ...
uma: 1은 그래픽이 시스템 메모리를 함께 쓰는 통합 메모리 구조라는 표시입니다.
2. 결과 읽기
# 기대 출력(이 PC, 3회 평균)
| model                  |      size |  params | backend | ngl |  test |             t/s |
| llama 1B Q4_K - Medium | 762.81 MiB | 1.24 B | Vulkan  |  99 | pp512 | 5796.25 ± 44.51 |
| llama 1B Q4_K - Medium | 762.81 MiB | 1.24 B | Vulkan  |  99 |  tg64 |  199.45 ± 0.33 |
| qwen2 7B Q4_K - Medium |   4.36 GiB | 7.62 B | Vulkan  |  99 | pp512 |   604.31 ± 2.74 |
| qwen2 7B Q4_K - Medium |   4.36 GiB | 7.62 B | Vulkan  |  99 |  tg64 |   39.01 ± 1.12 |
| 모델 | pp512(읽기) | tg64(쓰기) |
|---|---|---|
| Llama 3.2 1B | 약 5,800토큰/초 | 약 199토큰/초 |
| Qwen2.5 7B | 약 600토큰/초 | 약 39토큰/초 |
- pp와 tg: pp(prompt processing)는 입력을 읽는 속도, tg(text generation)는 답을 만드는 속도입니다. 긴 문서를 넣는 일은 pp가, 대화 체감은 tg가 좌우합니다.
- ngl 99: 모든 층을 그래픽에 올렸다는 뜻입니다.
- 크기와 속도: 매개변수가 6배 커지자 생성 속도는 약 5.1배 느려졌고 입력 읽기는 약 9.6배 느려졌습니다.
- ±의 크기: 생성 속도의 표준편차는 1B가 0.33, 7B가 1.12였습니다. 모델 사이의 차이(199 대 39)에 비해 아주 작습니다.
- 비트 수 계산: 7B 모델은 4.36GiB, 7.62B 매개변수이므로 값 하나에 약 4.9비트(4.36 x 2^30 x 8 / 7.62 x 10^9)입니다. 1B는 5.16비트입니다.
Q4라는 이름보다 실제로는 조금 더 씁니다.
처음 글의 값을 고친 이유
이 글의 처음 판은 -r 1(한 번)로 잰 값을 적었고 1B 입력 읽기가 2,879, 7B가 292토큰/초였습니다. 3회 평균으로 다시 재니 두 값이 5,800과 600으로 두 배 가까이 높게 나왔고, 생성 속도도 160과 35에서 199와 39로 올랐습니다. 처음 값은 한 번만 잰 데다, 그때 같은 PC에 다른 모델이 막 올라온 상태였던 것으로 추정합니다. 이 글의 값은 모두 3회 평균으로 바꿨습니다. 한 번만 잰 벤치 숫자는 그대로 믿지 않는 것이 좋습니다.
더 해 보기: 입력 길이, 출력 길이, 플래시 어텐션, 그리고 시점에 따른 흔들림
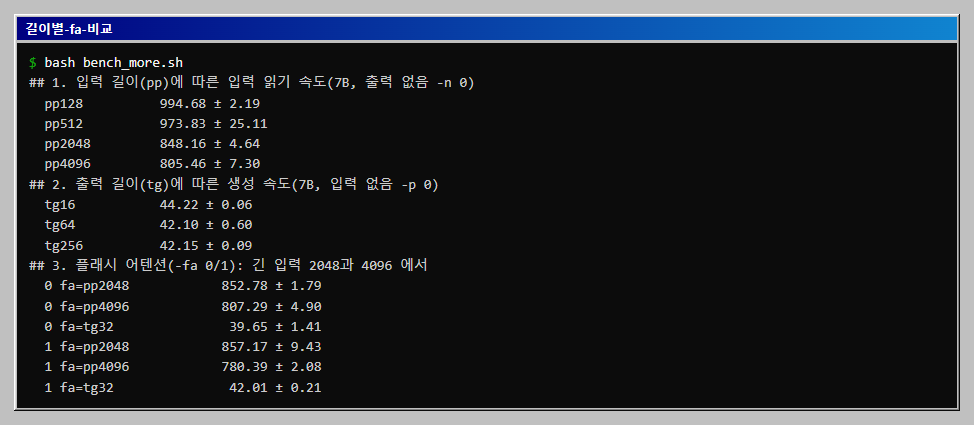
위 표는 입력 512토큰, 출력 64토큰 한 가지 조건의 값입니다. 입력과 출력의 길이를 바꾸면 속도가 어떻게 달라지는지, -fa(플래시 어텐션) 옵션이 도움이 되는지를 7B 모델로 쟀습니다(bench_more.sh, 모두 3회 평균).
입력 길이에 따른 읽기 속도(pp)
| 입력 토큰 | 읽기 속도 |
|---|---|
| 128 | 995 ± 2 토큰/초 |
| 512 | 974 ± 25 토큰/초 |
| 2,048 | 848 ± 5 토큰/초 |
| 4,096 | 805 ± 7 토큰/초 |
입력이 길수록 읽기 속도가 조금씩 떨어졌습니다. 128토큰에서 4,096토큰으로 32배 늘 때 속도는 19% 줄었습니다. 입력이 두 배가 되면 걸리는 시간이 두 배보다 약간 더 늘어나는 정도이고, 긴 문서를 넣는 일이 특별히 느려지지는 않았습니다. 4,096토큰 입력을 읽는 데 약 5초(4096 ÷ 805)가 걸립니다.
출력 길이에 따른 생성 속도(tg)
| 출력 토큰 | 생성 속도 |
|---|---|
| 16 | 44.2 ± 0.1 토큰/초 |
| 64 | 42.1 ± 0.6 토큰/초 |
| 256 | 42.2 ± 0.1 토큰/초 |
16토큰에서만 조금 빠르고 64와 256은 같았습니다. 생성 속도는 출력 길이와 거의 상관이 없고 초당 42토큰 안팎으로 일정합니다. 그래서 답의 길이에 비례해 시간이 걸린다고 계산해도 됩니다. 256토큰 답은 약 6초입니다.
플래시 어텐션(-fa 1)
| 시험 | -fa 0(기본) |
-fa 1 |
|---|---|---|
| 입력 2,048 읽기 | 853 ± 2 | 857 ± 9 |
| 입력 4,096 읽기 | 807 ± 5 | 780 ± 2 |
| 출력 32 생성 | 39.7 ± 1.4 | 42.0 ± 0.2 |
플래시 어텐션은 긴 입력에서 메모리와 속도를 아끼는 기법이지만, 이 PC의 Vulkan 빌드와 이 모델에서는 눈에 띄는 이득이 없었습니다. 입력 2,048에서는 같았고 4,096에서는 오히려 3% 느렸으며, 생성은 5% 빨랐지만 -fa 0의 표준편차(1.4)가 커서 차이라고 말하기 어렵습니다. 옵션은 기본값(꺼짐)으로 두고, 더 긴 입력이나 다른 그래픽에서는 직접 재 보고 정합니다. 이 글에서 4,096보다 긴 입력은 시험하지 않았습니다.
같은 7B의 읽기 속도가 시점에 따라 달랐습니다
2절의 표에서 7B 입력 512토큰 읽기는 약 600토큰/초였고 그날 네 번 실행해도 596에서 613 사이로 비슷했습니다. 그런데 이 절의 시험에서는 같은 조건이 974토큰/초로 나왔습니다. 같은 모델, 같은 옵션, 같은 PC입니다. 원인이 시점 차이인지 확인하려고 몇 시간 간격으로 다시 쟀습니다.
| 시험 | 7B 입력 512 읽기 | 7B 출력 64 생성 |
|---|---|---|
| 앞의 표(2절)와 그날의 반복 | 596 ~ 613 | 38.6 ~ 39.6 |
| 이 절의 길이별 시험 | 974 | (출력 없음) |
bench_gguf.sh 재실행 |
950 | 40.7 |
| 같은 명령 다시 한 번 | 836 | 40.4 |
입력만(-n 0) 다시 |
812 ± 116 | (출력 없음) |
생성 속도(38.6에서 40.7)는 일정했는데 입력 읽기는 600에서 974까지 1.6배 흔들렸습니다. 한 번 실행 안의 표준편차는 작아서(2.8~27) 3회 평균 안에서는 일관되지만, 몇 시간 간격으로 보면 달랐습니다. 이 PC는 다른 프로그램(예: 다른 모델을 서비스하는 Ollama)이 같은 내장 그래픽을 함께 쓰고 있어서, 그 시점의 사용량이 입력 읽기 속도에 영향을 주는 것으로 추정하지만 원인은 확인하지 않았습니다. 그래픽을 쓰는 다른 프로세스를 끄고 재는 시험은 이 글에서 하지 않았습니다.
여기서 얻는 교훈은 두 가지입니다. 한 번의 반복(-r 3)이 안정적이라고 해서 다른 시점의 값과 같다는 뜻은 아닙니다. 그리고 생성 속도(tg)는 이 PC에서 안정적이었고 입력 읽기 속도(pp)는 흔들렸으므로, 두 값 중 하나만 결과로 인용할 때는 어느 쪽인지, 어느 시점에 쟀는지를 같이 적습니다. 위 표(약 600토큰/초)를 다른 값과 비교할 때는 이 점을 감안합니다.
bench_more.sh는 아래와 같습니다.
#!/usr/bin/env bash
# llama-bench 심화: 입력 길이(pp)별 속도, 출력 길이(tg)별 속도, 플래시 어텐션(-fa) 켜기/끄기 비교. 모두 3회 평균.
# 준비: llama.cpp Vulkan 빌드(llama-bench.exe), GGUF 모델(Qwen2.5-7B)
# 실행(Git Bash): bash bench_more.sh   (약 2분)
LLAMA=/c/llama.cpp
M7=/c/models/Qwen2.5-7B-Instruct-Q4_K_M.gguf
cd "$LLAMA" || exit 1

show() {   # llama-bench 표에서 시험 이름과 속도 열만 보여 준다
  tr -d '\r' | awk -F'|' '$2 ~ /qwen|llama/ {gsub(/^ +| +$/, "", $7); gsub(/^ +/, "", $8); gsub(/^ +| +$/, "", $6); printf "  %-14s %s\n", $7 (NF>9 ? " fa=" $8 : ""), (NF>9 ? $9 : $8)}'
}

echo "## 1. 입력 길이(pp)에 따른 입력 읽기 속도(7B, 출력 없음 -n 0)"
./llama-bench.exe -m "$M7" -p 128,512,2048,4096 -n 0 -r 3 2>/dev/null | show

echo "## 2. 출력 길이(tg)에 따른 생성 속도(7B, 입력 없음 -p 0)"
./llama-bench.exe -m "$M7" -p 0 -n 16,64,256 -r 3 2>/dev/null | show

echo "## 3. 플래시 어텐션(-fa 0/1): 긴 입력 2048과 4096 에서"
./llama-bench.exe -m "$M7" -p 2048,4096 -n 32 -fa 0,1 -r 3 2>/dev/null | show
전체 코드
위 측정을 한 번에 실행하는 파일입니다. bench_gguf.sh로 저장하고 모델 경로 세 줄(LLAMA, M1, M7)만 내 PC에 맞게 고친 뒤 bash bench_gguf.sh로 실행합니다. 이 PC에서는 약 20초가 걸렸습니다.
# bench_gguf.sh
#!/usr/bin/env bash
# llama-bench 로 GGUF 모델 두 개의 입력 읽기(pp)와 생성(tg) 속도를 3회 평균으로 재고, 파일 크기에서 비트 수를 계산한다.
# 준비: llama.cpp Vulkan 빌드(llama-bench.exe), GGUF 모델 두 개, 파이썬(비트 수 계산용)
# 실행(Git Bash): bash bench_gguf.sh   (약 1분)
LLAMA=/c/llama.cpp
M1=/c/models/Llama-3.2-1B-Instruct-Q4_K_M.gguf
M7=/c/models/Qwen2.5-7B-Instruct-Q4_K_M.gguf

cd "$LLAMA" || exit 1

echo "## 1. 그래픽 장치"
./llama-bench.exe -m "$M1" -p 16 -n 1 -r 1 2>&1 | tr -d '
' | grep -E 'Found|uma' | cut -c1-110

echo "## 2. 속도(3회 평균, 표준편차 포함)"
./llama-bench.exe -m "$M1" -m "$M7" -p 512 -n 64 -r 3 2>/dev/null | tr -d '
' |
  awk -F'|' '$2 ~ /llama|qwen/ {gsub(/^ +| +$/, "", $2); gsub(/^ +| +$/, "", $3); gsub(/ +/, "", $7); gsub(/^ +/, "", $8); printf "%-24s %-10s %-6s %s
", $2, $3, $7, $8}'

echo "## 3. 파일 크기에서 계산한 값 하나당 비트 수"
python -X utf8 - <<'PY'
# (이름, 파일 크기 GiB, 매개변수 B) -- 2번 표의 size, params 열 값
for name, gib, b in (("1B", 762.81 / 1024, 1.24), ("7B", 4.36, 7.62)):
    print(f"{name}: {gib * 2**30 * 8 / (b * 1e9):.2f} 비트")
PY
3. Ollama 결과와 비교할 때 주의
같은 PC에서 Ollama로 잰 gemma4:31b는 초당 약 16토큰이고 이 글의 7B는 약 39토큰입니다. 그러나 모델 종류, 양자화 방식, 측정 방법(실제 대화와 벤치 도구)이 모두 달라서 두 숫자를 엔진의 우열로 읽으면 안 됩니다. 엔진을 비교하려면 같은 GGUF 모델을 두 쪽에서 같은 조건으로 재야 하는데, 이 글에서는 하지 않았습니다.
자주 막히는 곳
| 증상 | 원인과 해결 |
|---|---|
| Vulkan 장치를 못 찾음 | 그래픽 드라이버를 최신으로 갱신. 이 글은 Vulkan 빌드만 실행 |
| 모델이 메모리에 안 올라감 | -ngl 값을 줄여 일부 층만 그래픽에 올림. 이 글에서는 시험하지 않음 |
| 결과가 실행마다 다름 | -r 1은 한 번만 측정. -r 3 이상으로 평균 계산. 처음 판의 값이 절반이었던 이유 |
| 측정 중 다른 프로그램이 느려짐 | 큰 모델은 메모리 대부분을 사용. 다른 모델 서버를 먼저 내림 |
확인 범위
- 해 본 것: 29일에 bench_more.sh로 입력 길이 네 가지, 출력 길이 세 가지, -fa 0과 1을 3회 평균으로 쟀고, 몇 시간 간격으로 같은 7B 시험을 다시 해 읽기 속도가 600에서 974까지 달랐던 것을 확인했습니다. 앞의 확인 내용은 다음과 같습니다. 2026-10-28에
-r 1로, 29일에-r 3으로 Windows 11 · llama.cpp 빌드 9050 · Vulkan 백엔드에서llama-bench를 실행했습니다. 29일에 전체 스크립트를 네 번 실행해 1B 읽기 5,7005,900, 7B 읽기 596613으로 값이 서로 가까운 것을 확인했습니다. - 해 보지 않은 것: 그래픽을 쓰는 다른 프로세스를 끄고 재는 시험, 4096보다 긴 입력, -ub와 -b 값 변경, CPU만 쓰는 경우, CUDA와 Metal 빌드, 다른 양자화(Q8, Q2 등), 직접 빌드하는 과정.
- 읽을 때 주의: 측정 중에도 같은 PC에 Ollama 모델 세 개가 올라 있었습니다(메모리만 차지하고 요청은 없었습니다). 이 PC의 값이며 다른 그래픽과 드라이버에서는 다릅니다.
이 글은 Ollama와 로컬 LLM 실습 로드맵의 한 단계입니다.
이 글의 다음 단계
- llama.cpp -ngl로 그래픽 가속 켜고 끄기: 1B와 7B 속도 차이와 중간 값 측정llama-bench의 -ngl 값을 99와 0으로 바꿔 1B와 7B 모델을 재고, 7B는 28층 중 0, 7, 14, 21, 28층만 올린 중간 값도 잽니다. 생성 속도는 2.6배에서 3.2배, 입력 읽기는 2.2배에서 3.1배 차이가 났고, 처음 측정값이 반복 측정에서 재현되지 않은 부분도 정정합니다.
- llama-server로 내 PC에 OpenAI 호환 API 열기llama.cpp의 llama-server에 GGUF 모델을 올려 OpenAI와 같은 형식의 /v1/chat/completions 주소를 만듭니다. 127.0.0.1에만 열고, requests와 openai 파이썬 라이브러리로 호출해 한 번에 받기와 스트리밍을 확인합니다.
이 내용을 팀 교육으로 진행하고 싶으신가요?
인원, 수준, 일정에 맞춰 실습 환경까지 준비해 진행합니다. 대상과 기간을 알려 주시면 구성을 제안해 드립니다.
교육 문의하기메일로 보내실 수도 있습니다: fankh111@gmail.com