집 PC의 Ollama를 여러 프로그램이나 여러 사람이 함께 쓰면 요청이 동시에 들어옵니다. 요청이 많아지면 서로 느려지는지, 전체 일은 더 빨리 끝나는지가 궁금해집니다. 이 글에서는 같은 질문을 동시에 1, 2, 4, 8개 보내 보고 결과를 해석합니다.
준비물
| 항목 | 확인한 값 |
|---|---|
| Ollama | 0.32.15 (Windows 11), 병렬 처리 환경 변수(OLLAMA_NUM_PARALLEL)는 설정하지 않은 상태 |
| 모델 | exaone3.5:2.4b |
| PC | AMD Ryzen AI Max+ 395, 메모리 약 96GB |
1. 측정 스크립트
파이썬 스레드로 요청을 동시에 보내고, 시작부터 마지막 응답까지의 전체 시간과 요청별 지연을 잽니다. 모델은 미리 한 번 불러 두어 로딩 시간이 섞이지 않게 합니다.
import requests, time, threading

U = "http://localhost:11434/api/chat"
Q = "로컬 AI를 쓰는 이유를 세 가지 말해 주세요."

def one(res, i):
    t = time.time()
    d = requests.post(U, json={"model": "exaone3.5:2.4b", "stream": False,
        "messages": [{"role": "user", "content": Q}],
        "options": {"temperature": 0.2, "num_predict": 150}}, timeout=600).json()
    res[i] = (d["eval_count"], time.time() - t, d["eval_count"] / (d["eval_duration"] / 1e9))

for n in (1, 2, 4, 8):
    res = [None] * n
    ths = [threading.Thread(target=one, args=(res, i)) for i in range(n)]
    t = time.time(); [x.start() for x in ths]; [x.join() for x in ths]; wall = time.time() - t
    tot = sum(r[0] for r in res)
    print(f"n={n} wall {wall:.1f}s total {tot} tok -> {tot/wall:.0f} tok/s aggregate"
          f" | per-request eval {sum(r[2] for r in res)/n:.0f} tok/s, latency {sum(r[1] for r in res)/n:.1f}s")
2. 결과
# 기대 출력(이 PC)
n=1 wall 3.6s  total 150 tok  -> 42 tok/s aggregate | per-request eval 100 tok/s, latency 3.6s
n=2 wall 5.1s  total 300 tok  -> 59 tok/s aggregate | per-request eval 99 tok/s, latency 4.3s
n=4 wall 8.8s  total 600 tok  -> 68 tok/s aggregate | per-request eval 92 tok/s, latency 6.0s
n=8 wall 16.3s total 1200 tok -> 74 tok/s aggregate | per-request eval 88 tok/s, latency 9.9s
| 동시 요청 | 전체 걸린 시간 | 요청당 평균 지연 | 요청당 생성 속도 | 전체 처리량 |
|---|---|---|---|---|
| 1 | 3.6초 | 3.6초 | 약 100토큰/초 | 42토큰/초 |
| 2 | 5.1초 | 4.3초 | 약 99토큰/초 | 59토큰/초 |
| 4 | 8.8초 | 6.0초 | 약 92토큰/초 | 68토큰/초 |
| 8 | 16.3초 | 9.9초 | 약 88토큰/초 | 74토큰/초 |
| 16(29일 재측정) | 29.2초 | 16.3초 | 약 91토큰/초 | 82토큰/초 |
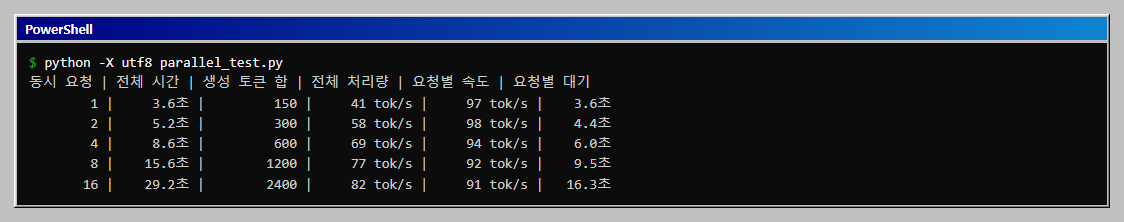
29일에 전체 스크립트로 다시 쟀을 때 1, 2, 4, 8개의 값은 처음과 비슷했습니다(전체 시간 3.6, 5.2, 8.6, 15.6초). 요청을 16개로 늘리면 전체 처리량은 82토큰/초로 8개일 때(같은 재측정에서 77)보다 조금만 올랐고, 요청당 대기는 16.3초가 됐습니다. 동시 요청을 늘려도 처리량 증가는 82 근처에서 완만해졌습니다. 같은 모델에서 한 번씩 잰 값입니다.
(전체 처리량은 만든 토큰 합계를 전체 걸린 시간으로 나눈 값이라 요청당 생성 속도보다 낮습니다. 요청마다 입력을 읽는 시간과 통신 시간이 포함되기 때문입니다.)
3. 읽는 법
- 요청당 생성 속도는 거의 그대로입니다. 8개를 동시에 보내도 개별 요청의 생성 속도는 100에서 88토큰/초로 약간만 줄었습니다. 동시에 나눠서 계산했다면 속도가 크게 떨어졌을 것입니다.
- 대신 기다리는 시간이 늘었습니다. 평균 지연이 3.6초에서 9.9초가 됐습니다. 마지막 요청은 앞 요청들이 끝나기를 기다렸다고 추정합니다.
- 전체 처리량은 조금 올랐습니다. 42에서 74토큰/초입니다. 한 요청이 입력을 읽거나 응답을 주고받는 동안 다음 요청이 이어서 처리되어 빈 시간이 줄어든 것으로 추정하지만, 내부 동작은 확인하지 않았습니다.
정리하면 이 설정에서는 동시 요청이 줄 서서 처리되는 모양이었고, 요청을 늘려도 전체 일이 크게 빨라지지는 않았습니다.
4. 병렬 처리 설정
Ollama에는 같은 모델에서 요청을 동시에 처리하게 하는 OLLAMA_NUM_PARALLEL 환경 변수가 있습니다. 서버를 시작할 때 읽는 값이라 바꾸려면 Ollama를 다시 시작해야 합니다. 동시 처리 수를 늘리면 요청마다 컨텍스트 공간이 필요해 메모리를 더 씁니다. 본 서비스 설정은 바꾸지 않았고, 이 변수의 효과와 메모리 사용량은 아래 더 해 보기 절에서 임시 서버로 쟀습니다.
더 해 보기: OLLAMA_NUM_PARALLEL을 바꾸면
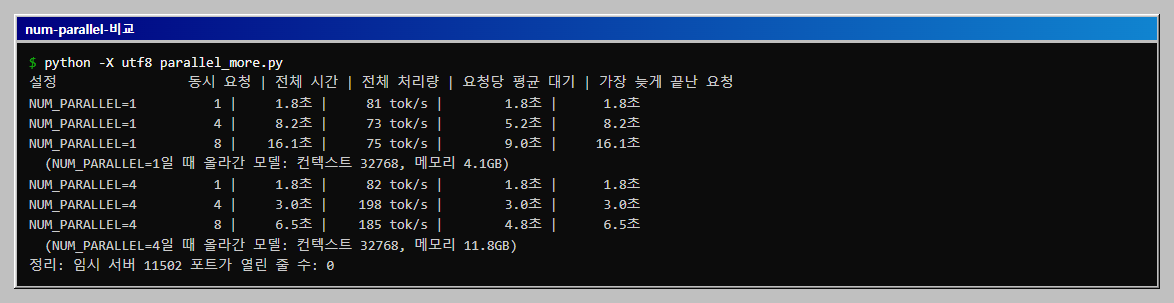
위 표에서 동시 요청을 늘려도 전체 처리량이 80토큰/초 안팎에서 더 늘지 않았습니다. 이 PC의 Ollama가 요청을 한 번에 하나씩 처리하는 설정으로 돌고 있어서일 가능성이 있습니다. 서버 설정 OLLAMA_NUM_PARALLEL은 모델 하나가 동시에 처리하는 요청 수를 정합니다. 이 값을 바꾸면 무엇이 달라지는지, 본 서비스(11434)를 건드리지 않고 11502 포트에 임시 서버를 설정마다 새로 띄워 같은 시험을 해 보았습니다(parallel_more.py).
| 설정 | 동시 요청 | 전체 시간 | 전체 처리량 | 요청당 평균 대기 | 가장 늦게 끝난 요청 |
|---|---|---|---|---|---|
NUM_PARALLEL=1 |
1 | 1.8초 | 81토큰/초 | 1.8초 | 1.8초 |
NUM_PARALLEL=1 |
4 | 8.2초 | 73토큰/초 | 5.2초 | 8.2초 |
NUM_PARALLEL=1 |
8 | 16.1초 | 75토큰/초 | 9.0초 | 16.1초 |
NUM_PARALLEL=4 |
1 | 1.8초 | 82토큰/초 | 1.8초 | 1.8초 |
NUM_PARALLEL=4 |
4 | 3.0초 | 198토큰/초 | 3.0초 | 3.0초 |
NUM_PARALLEL=4 |
8 | 6.5초 | 185토큰/초 | 4.8초 | 6.5초 |
표에서 알 수 있는 것은 세 가지입니다.
NUM_PARALLEL=1에서는 앞의 표와 같은 모양이 다시 나왔습니다. 요청 4개는 8.2초, 8개는 16.1초로 요청 수에 거의 비례해 길어졌고 전체 처리량은 73~75토큰/초로 늘지 않았습니다. 요청이 한 줄로 서서 차례를 기다리는 모습입니다. 본 서비스의 앞선 측정도 같은 모양이어서, 본 서비스가 동시 처리 1에 가깝게 돌고 있다고 추정하지만 본 서비스의 설정 값 자체는 확인하지 않았습니다.NUM_PARALLEL=4에서는 처리량이 두 배 반이 되었습니다. 요청 4개가 3.0초에 모두 끝났고(처리량 198토큰/초), 8개도 6.5초(185토큰/초)였습니다. 요청 하나일 때의 속도(82토큰/초)는 그대로이므로, 요청이 하나뿐인 사용자는 달라지는 것이 없고 여러 명이 동시에 쓸 때만 이득입니다.- 대신 메모리를 더 씁니다. 같은 모델이
NUM_PARALLEL=1에서는 4.1GB,4에서는 11.8GB로 올라갔습니다(/api/ps의 크기). 동시에 처리할 요청마다 기억 공간(컨텍스트)을 따로 잡아서 모델 크기에 비해 커집니다. 모델이 큰 경우에는 값을 올리면 메모리가 모자랄 수 있습니다. 이 글의 모델은 1.6GB로 작아서 문제가 없었습니다.
요청 8개에서 NUM_PARALLEL=4의 가장 늦은 요청은 6.5초였고 평균 대기는 4.8초였습니다. 동시 처리 수보다 요청이 많으면 나머지는 줄을 서서 앞 요청이 끝나기를 기다린다고 추정합니다. 이 글에서 대기열의 한도(OLLAMA_MAX_QUEUE)는 시험하지 않았습니다.
정리하면, 한 사람이 쓰는 PC라면 기본값으로 충분하고, 여러 사람이나 여러 프로그램이 한 서버를 함께 쓰면 OLLAMA_NUM_PARALLEL을 올리는 것이 가장 큰 효과를 내는 설정입니다. 서비스에 적용할 때는 환경 변수를 설정하고 서비스를 다시 시작합니다. 이 글에서는 본 서비스를 바꾸지 않고 임시 서버에서만 시험했습니다.
parallel_more.py는 아래와 같습니다. 임시 서버를 설정마다 새로 띄우고 끝에서 그 서버만 끕니다.
"""Ollama 동시 요청 심화: OLLAMA_NUM_PARALLEL 을 1, 4 로 바꾼 임시 서버에서 같은 시험을 해 처리량과 대기를 비교한다.

준비: Ollama 설치, ollama pull exaone3.5:2.4b, pip install requests
주의: 본 서비스(11434)는 건드리지 않고 11502 포트에 임시 서버를 설정마다 새로 띄운다. 끝에서 이 서버만 끈다.
실행: python -X utf8 parallel_more.py   (약 2분)
"""
import os
import subprocess
import threading
import time

import requests

PORT = 11502
URL = f"http://127.0.0.1:{PORT}/api/chat"
MODEL = "exaone3.5:2.4b"
Q = "로컬 AI를 쓰는 이유를 세 가지 말해 주세요."


def start(parallel):
    env = dict(os.environ, OLLAMA_HOST=f"127.0.0.1:{PORT}", OLLAMA_NUM_PARALLEL=str(parallel), OLLAMA_KEEP_ALIVE="5m")
    p = subprocess.Popen(["ollama", "serve"], env=env, stdout=subprocess.DEVNULL, stderr=subprocess.DEVNULL)
    for _ in range(30):
        try:
            requests.get(f"http://127.0.0.1:{PORT}/api/version", timeout=1)
            break
        except requests.RequestException:
            time.sleep(1)
    return p


def one(res, i):
    t = time.time()
    d = requests.post(URL, json={"model": MODEL, "stream": False, "messages": [{"role": "user", "content": Q}],
                                 "options": {"temperature": 0.2, "num_predict": 150}}, timeout=600).json()
    res[i] = (d["eval_count"], time.time() - t)


def ctx_and_mem():
    for m in requests.get(f"http://127.0.0.1:{PORT}/api/ps").json()["models"]:
        return m.get("context_length"), m["size"] / 1e9
    return None, None


print("설정                 동시 요청 | 전체 시간 | 전체 처리량 | 요청당 평균 대기 | 가장 늦게 끝난 요청")
for parallel in (1, 4):
    srv = start(parallel)
    try:
        requests.post(URL, json={"model": MODEL, "stream": False, "messages": [{"role": "user", "content": "hi"}],
                                 "options": {"num_predict": 2}})     # 모델을 먼저 올려 둔다
        for n in (1, 4, 8):
            res = [None] * n
            ths = [threading.Thread(target=one, args=(res, i)) for i in range(n)]
            t = time.time()
            [x.start() for x in ths]
            [x.join() for x in ths]
            wall = time.time() - t
            tot = sum(r[0] for r in res)
            print(f"NUM_PARALLEL={parallel:<2}{n:>10} | {wall:7.1f}초 | {tot / wall:6.0f} tok/s | "
                  f"{sum(r[1] for r in res) / n:10.1f}초 | {max(r[1] for r in res):8.1f}초")
        c, g = ctx_and_mem()
        print(f"  (NUM_PARALLEL={parallel}일 때 올라간 모델: 컨텍스트 {c}, 메모리 {g:.1f}GB)")
    finally:
        srv.terminate()
        srv.wait(timeout=30)
        time.sleep(2)

r = subprocess.run(["netstat", "-ano"], capture_output=True, text=True).stdout
print("정리: 임시 서버 11502 포트가 열린 줄 수:", sum(1 for l in r.splitlines() if f":{PORT} " in l and "LISTENING" in l))
전체 코드
아래 파일 하나가 동시 요청 1, 2, 4, 8, 16개를 차례로 재서 표로 출력합니다(약 1분). 그대로 복사해 parallel_test.py로 저장하고 python -X utf8 parallel_test.py로 실행합니다.
# parallel_test.py
"""Ollama 동시 요청: 같은 질문을 1, 2, 4, 8, 16개 동시에 보내 전체 처리량과 요청별 속도를 잰다.

준비: Ollama 실행 중, ollama pull exaone3.5:2.4b, pip install requests
주의: 서버 설정(OLLAMA_NUM_PARALLEL)은 바꾸지 않는다. 이 PC의 기본 동작을 그대로 잰다.
실행: python -X utf8 parallel_test.py   (약 1분)
"""
import threading
import time
import requests

URL = "http://localhost:11434/api/chat"
MODEL = "exaone3.5:2.4b"
Q = "로컬 AI를 쓰는 이유를 세 가지 말해 주세요."


def one(res, i):
    t = time.time()
    d = requests.post(URL, json={"model": MODEL, "stream": False,
                                 "messages": [{"role": "user", "content": Q}],
                                 "options": {"temperature": 0.2, "num_predict": 150}}, timeout=600).json()
    # (생성 토큰 수, 이 요청이 끝날 때까지 걸린 초, 이 요청의 생성 속도)
    res[i] = (d["eval_count"], time.time() - t, d["eval_count"] / (d["eval_duration"] / 1e9))


# 모델을 먼저 올려 두어 불러오는 시간이 결과에 섞이지 않게 한다
requests.post(URL, json={"model": MODEL, "stream": False,
                         "messages": [{"role": "user", "content": "hi"}], "options": {"num_predict": 2}})

print("동시 요청 | 전체 시간 | 생성 토큰 합 | 전체 처리량 | 요청별 속도 | 요청별 대기")
for n in (1, 2, 4, 8, 16):
    res = [None] * n
    ths = [threading.Thread(target=one, args=(res, i)) for i in range(n)]
    t = time.time()
    [x.start() for x in ths]
    [x.join() for x in ths]
    wall = time.time() - t
    tot = sum(r[0] for r in res)
    print(f"{n:9d} | {wall:7.1f}초 | {tot:11d} | {tot / wall:6.0f} tok/s | "
          f"{sum(r[2] for r in res) / n:6.0f} tok/s | {sum(r[1] for r in res) / n:6.1f}초")
자주 막히는 곳
| 증상 | 원인과 해결 |
|---|---|
| 동시에 보냈는데 응답이 순서대로 하나씩 옵니다 | 이 글의 결과처럼 줄 서서 처리되는 상태일 수 있습니다. 병렬 설정을 확인합니다 |
| 일부 요청이 시간 초과로 실패합니다 | 요청이 많으면 뒤쪽이 오래 기다립니다. timeout을 늘리거나 보내는 쪽에서 개수를 제한합니다 |
| 첫 요청만 유난히 깁니다 | 모델 로딩입니다. 측정 전에 한 번 불러 둡니다 |
확인 범위
- 해 본 것: 29일에 임시 서버(11502)에서 OLLAMA_NUM_PARALLEL 1과 4로 같은 시험을 해 처리량, 대기, 메모리를 비교했습니다. 앞의 확인 내용은 다음과 같습니다. 2026-10-28, Windows 11 · Ollama 0.32.15,
exaone3.5:2.4b로 동시 요청 수마다 한 번씩 쟀습니다. 요청은 모두 같은 짧은 질문이고 답은 150토큰으로 제한했습니다. - 29일 재측정: 전체 스크립트(위)를 다시 실행해 1, 2, 4, 8개를 재확인하고 16개를 추가했습니다. 한 번씩 잰 값입니다.
- 해 보지 않은 것: OLLAMA_MAX_QUEUE와 대기열 한도, 큰 모델에서의 처리량과 메모리 부족, 긴 입력, 별도 그래픽 카드가 있는 PC, Linux와 macOS.
이 글은 Ollama와 로컬 LLM 실습 로드맵의 한 단계입니다.
이 글의 다음 단계
- 집 PC에서 로컬 AI 돌리기: 메모리로 모델 크기 고르고 속도 재 보기Ollama로 내 PC에서 AI 모델을 돌릴 때 가장 먼저 부딪히는 질문, 어떤 크기의 모델이 내 컴퓨터에 맞는지를 다룹니다. 모델 파일 크기와 메모리의 관계를 계산하고, 2.4B 모델과 31B 모델을 같은 PC에서 돌려 초당 토큰 수를 직접 비교합니다.
- 한국어로 물어 본 로컬 모델 4종 비교: 2.4B, 3B, 27B, 31B같은 PC에서 exaone3.5 2.4B, qwen2.5 3B, qwen3.8 27B, gemma4 31B에 한국어 질문 다섯 개를 보내 속도와 답을 비교합니다. 작은 모델이 틀린 곳과 큰 모델이 느린 만큼 얻는 것을 실제 답으로 확인합니다.
이 내용을 팀 교육으로 진행하고 싶으신가요?
인원, 수준, 일정에 맞춰 실습 환경까지 준비해 진행합니다. 대상과 기간을 알려 주시면 구성을 제안해 드립니다.
교육 문의하기메일로 보내실 수도 있습니다: fankh111@gmail.com