임베딩은 문장을 숫자 목록(벡터)으로 바꿔서, 뜻이 비슷한 문장끼리 가까운 값을 갖게 하는 방법입니다. 문서 검색, 중복 찾기, RAG의 바탕이 됩니다. 이 글에서는 Ollama의 임베딩 모델로 한국어 문장 일곱 개를 벡터로 만들고, 어떤 문장끼리 가깝게 나오는지 봅니다. 잘 되는 곳과 함께 점수를 믿으면 안 되는 곳도 확인합니다.
준비물
| 항목 | 확인한 값 |
|---|---|
| Ollama | 0.32.15, 모델 nomic-embed-text (274MB) |
| Python | 3.12.10, requests, numpy 2.5.2 |
1. 벡터 만들기
/api/embed에 문장 목록을 한 번에 보내면 문장마다 벡터가 돌아옵니다.
import requests, numpy as np

S = ["비밀번호를 잊어버렸을 때 재설정하는 방법",
     "계정 암호 복구 절차 안내",
     "점심 메뉴로 김치찌개를 먹었다",
     "오늘 저녁에는 된장찌개가 먹고 싶다",
     "서버 디스크 사용량이 90퍼센트를 넘었다",
     "저장 공간이 부족해서 로그 파일을 지웠다",
     "다음 주 월요일 오전 10시에 회의가 있습니다"]
r = requests.post("http://localhost:11434/api/embed",
                  json={"model": "nomic-embed-text", "input": S}).json()
E = np.array(r["embeddings"])
print(E.shape)
# 기대 출력
(7, 768)
문장 하나가 768개의 숫자가 됩니다.
2. 코사인 유사도
두 벡터의 방향이 얼마나 같은지 보는 값입니다. 길이를 1로 맞춘 뒤 내적하면 됩니다. 1에 가까울수록 비슷합니다.
E = E / np.linalg.norm(E, axis=1, keepdims=True)
M = E @ E.T
for i, s in enumerate(S):
    j = max((k for k in range(len(S)) if k != i), key=lambda k: M[i, k])
    print(f"{i} -> {j} sim {M[i, j]:.3f} | {s[:16]} / {S[j][:16]}")
# 기대 출력(이 PC)
0 -> 1 sim 0.852 | 비밀번호를 잊어버렸을 때 재설 / 계정 암호 복구 절차 안내
1 -> 0 sim 0.852 | 계정 암호 복구 절차 안내 / 비밀번호를 잊어버렸을 때 재설
2 -> 3 sim 0.915 | 점심 메뉴로 김치찌개를 먹었다 / 오늘 저녁에는 된장찌개가 먹고
3 -> 2 sim 0.915 | 오늘 저녁에는 된장찌개가 먹고 싶다 / 점심 메뉴로 김치찌개를 먹었다
4 -> 0 sim 0.707 | 서버 디스크 사용량이 90퍼센 / 비밀번호를 잊어버렸을 때 재설
5 -> 1 sim 0.846 | 저장 공간이 부족해서 로그 파일을 지웠다 / 계정 암호 복구 절차 안내
6 -> 5 sim 0.695 | 다음 주 월요일 오전 10시에 / 저장 공간이 부족해서 로그
전체 쌍의 점수를 7x7 표로 찍으면 더 잘 보입니다. 아래 화면은 전체 스크립트(embed_similarity.py)의 결과입니다.
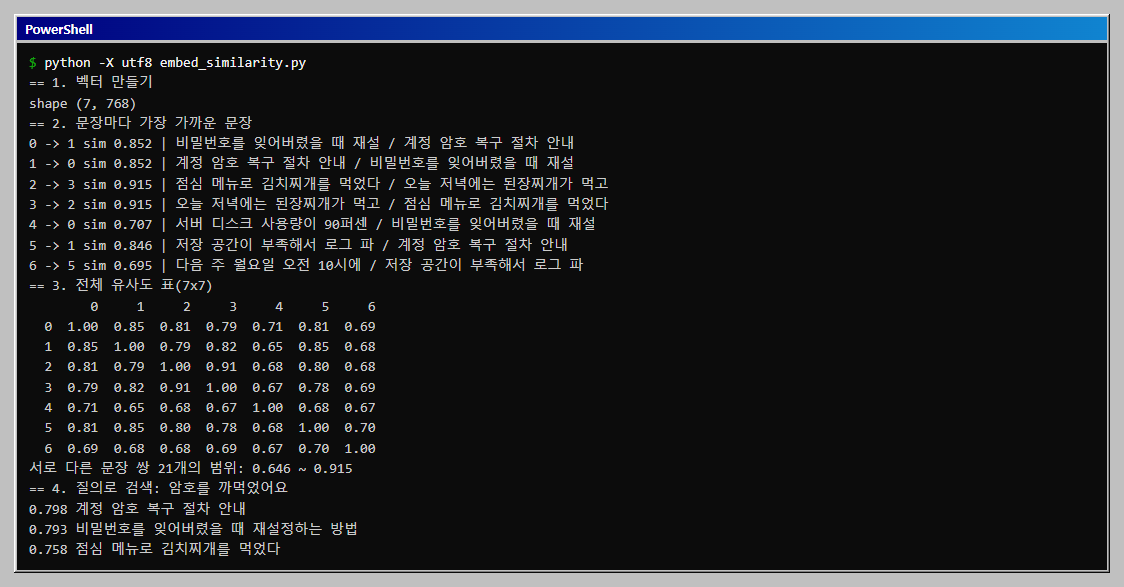
- 같은 뜻의 쌍(0과 1)은 0.85, 같은 주제의 음식 쌍(2와 3)은 0.91이고 서로 다른 주제는 대부분 0.65
0.82입니다. 한 줄(4번 서버 디스크)은 다른 모든 문장과 0.650.71로 낮았습니다. - 표에서 5번(저장 공간)은 1번(계정 암호 복구)과 0.85, 0번과 0.81로 4번(디스크)과의 0.68보다 높았습니다. 같은 용량 이야기인 4번과 5번이 서로 가장 가깝지 않다는 점이 이 모델 점수를 그대로 믿으면 안 되는 이유입니다.
3. 읽는 법
잘 되는 곳
- 단어가 거의 겹치지 않는 같은 뜻의 문장(
비밀번호 재설정과암호 복구)이 서로를 가장 가까운 문장으로 골랐습니다(0.852). - 음식 이야기 두 문장(김치찌개, 된장찌개)이 가장 높은 0.915로 묶였습니다.
조심할 곳
- 점수가 좁은 범위에 몰립니다. 일곱 문장의 모든 쌍에서 가장 낮은 값이 0.646, 가장 높은 값이 0.915였습니다. 관련 없는 문장끼리도 0.65 이상이 나오므로 "0.7이면 비슷하다" 같은 고정 기준을 바로 쓸 수 없습니다.
- 같은 주제의 문장이 오히려 낮게 나왔습니다. 디스크 사용량 문장(4번)과 저장 공간 부족 문장(5번)은 둘 다 서버 용량 이야기인데 유사도가 0.682였습니다. 4번의 최고 짝은 비밀번호 문장(0번, 0.707)이었고, 5번의 최고 짝은
계정 암호 복구(1번, 0.846)였습니다. 이 점수들만으로는 주제가 같은 문장을 항상 가려내지 못했습니다. - 관련 없는 문장도 높게 나올 수 있습니다. 질의
암호를 까먹었어요를 같은 방법으로 비교했더니 상위 결과가 이렇게 나왔습니다.
# 기대 출력
query top: 0.798 계정 암호 복구 절차 안내
query top: 0.793 비밀번호를 잊어버렸을 때 재설정하는 방법
query top: 0.758 점심 메뉴로 김치찌개를 먹었다
위의 두 결과는 올바르게 1, 2위에 올랐지만, 3위의 점심 메뉴 문장도 0.758로 1위와 0.04밖에 차이 나지 않습니다.
4. 쓰는 방법
- 점수의 절대값보다 순위를 씁니다. 질문과 가장 가까운 상위 몇 개를 고르는 방식이 안전합니다.
- 기준선을 쓰려면 내 데이터로 정합니다. 관련 있는 쌍과 없는 쌍을 직접 몇십 개 모아 점수 분포를 보고 정합니다.
- 한국어에 맞춘 임베딩 모델과 비교합니다. 이 글의 모델은 한국어 전용이 아닙니다. 다른 모델(bge-m3)과의 비교는 아래 더 해 보기 절에서 문서 검색으로 했습니다.
더 해 보기: 질문으로 문서 찾기, 모델 두 개 비교
위 표의 점수는 문장 쌍이 얼마나 비슷한지만 보여 줍니다. 임베딩이 실제로 가장 흔히 쓰이는 곳은 "질문을 주면 문서 모음에서 맞는 문서를 찾는" 검색입니다. 사내 안내문 열두 개와, 문서의 낱말을 일부러 피해 다르게 적은 질문 열두 개(예: 문서의 "비밀번호"를 "암호가 기억나지 않아요"로)로 이 검색을 시험했습니다. 질문마다 맞는 문서가 정해져 있고, 모든 점수는 방향만 비교하는 코사인 유사도입니다(emb_more.py).
| 문서 | 질문 |
|---|---|
| 비밀번호를 잊었을 때 재설정 링크로 이메일 인증을 거친다 | 암호가 기억나지 않아요 |
| 연차는 입사 1년 뒤부터 15일이 주어진다 | 쉬는 날은 며칠이나 쓸 수 있나요 |
| 노트북을 분실하면 즉시 보안팀에 알리고 원격 삭제를 요청한다 | 컴퓨터를 잃어버렸어요 |
| 퇴사자의 계정은 마지막 근무일에 비활성화한다 | 그만둔 직원의 아이디는 어떻게 처리하나요 |
결과: 모델에 따라 하늘과 땅
이 글의 nomic-embed-text와, 한국어를 포함한 여러 언어용으로 만들어진 bge-m3(1.2GB, ollama pull bge-m3)를 비교했습니다. nomic-embed-text는 문서 앞에 search_document: , 질문 앞에 search_query: 를 붙이라고 안내되어 있어서 붙인 경우와 붙이지 않은 경우를 모두 쟀습니다.
| 모델 | 설정 | 1등이 정답 | 3등 안에 정답 | 정답 평균 점수 | 오답 평균 점수 | 점수 차 |
|---|---|---|---|---|---|---|
| nomic-embed-text | 접두어 없음 | 3/12 | 4/12 | 0.792 | 0.777 | 0.015 |
| nomic-embed-text | 접두어 사용 | 3/12 | 4/12 | 0.695 | 0.678 | 0.017 |
| bge-m3 | 접두어 없음 | 12/12 | 12/12 | 0.619 | 0.415 | 0.204 |
nomic-embed-text는 이 한국어 검색에서 12건 중 3건만 맞혔습니다. 정답 문서의 평균 점수(0.792)와 오답 문서의 평균 점수(0.777)가 거의 같아서(차이 0.015), 점수만으로는 맞는 문서를 가려낼 수 없었습니다. 접두어를 붙여도 같은 3건이었고 점수 차도 0.017로 달라지지 않았습니다. 앞의 문장 유사도 표에서 점수가 0.65~0.91 사이에 몰려 있던 것과 같은 현상입니다. 이 모델은 영어 중심으로 만들어져서 한국어를 구분하는 힘이 약한 것으로 추정합니다.bge-m3는 12건 모두 1등으로 맞혔습니다. 점수가 낮아 보이는 것(0.619)은 문제가 아닙니다. 중요한 것은 정답과 오답의 차이이고, 이 모델은 그 차이가 0.204로 14배 가까이 컸습니다. 모델마다 점수의 기준선이 다르므로 점수 크기를 모델끼리 비교하지 않습니다.- 한국어 문서 검색에는 한국어를 지원하는 임베딩 모델을 씁니다. 모델 이름만 바꾸면 되므로 비용은 거의 없고 효과는 컸습니다. 이 열두 건은 작은 시험이어서 일반적인 성능이라고 단정하지는 않습니다. 쓸 문서와 질문으로 직접 시험해 보는 것이 가장 확실합니다.
임계값을 정할 때
"점수가 이 값 이상이면 찾았다"는 기준을 정하려면 정답과 오답의 점수 분포를 보아야 합니다.
| 모델 | 기준 | 정답 중 통과 | 오답 중 잘못 통과 |
|---|---|---|---|
| nomic-embed-text | 0.5 | 12/12 | 132/132 |
| nomic-embed-text | 0.6 | 12/12 | 132/132 |
| nomic-embed-text | 0.7 | 4/12 | 38/132 |
| bge-m3 | 0.5 | 12/12 | 11/132 |
| bge-m3 | 0.6 | 9/12 | 0/132 |
| bge-m3 | 0.7 | 0/12 | 0/132 |
nomic-embed-text는 어떤 기준을 잡아도 정답만 통과시킬 수 없었습니다. 0.6에서는 오답이 전부 통과했고 0.7에서는 정답의 3분의 2가 탈락했습니다. bge-m3는 정답 점수의 최솟값이 0.561, 오답 점수의 최댓값이 0.560이어서 기준을 0.561 근처에 두면 이 열두 건에서는 완벽히 가를 수 있습니다. 다만 이 기준은 이 열두 건에만 맞춘 값이어서, 실제 서비스에서는 더 많은 질문으로 정하고 가끔 다시 점검합니다. 기준을 0.6으로 올리면 오답은 없지만 정답 세 건을 놓칩니다. 놓치지 않는 것이 중요하면 기준을 낮추고, 틀린 문서를 보여 주지 않는 것이 중요하면 높입니다.
상관없는 질문은 몇 점인가
문서와 전혀 상관없는 세 질문을 보냈습니다. 점심 메뉴, 축구 경기 결과, 영어로 빵 굽는 법입니다.
| 모델 | 질문 | 가장 높은 점수 |
|---|---|---|
| nomic-embed-text | 점심 메뉴 추천 | 0.719 |
| nomic-embed-text | 축구 경기 결과 | 0.708 |
| nomic-embed-text | How do I bake bread? | 0.438 |
| bge-m3 | 점심 메뉴 추천 | 0.405 |
| bge-m3 | 축구 경기 결과 | 0.389 |
| bge-m3 | How do I bake bread? | 0.323 |
nomic-embed-text는 상관없는 한국어 질문에도 0.7이 넘는 점수를 주어서, 이 점수로는 "찾는 문서가 없음"을 알아낼 수 없습니다. bge-m3는 0.3~0.4대로, 정답 최솟값(0.561)보다 한참 낮았습니다. 검색 결과가 없을 때 "해당하는 문서가 없습니다"라고 답하게 하려면 이런 분리가 되는 모델과 임계값이 필요합니다.
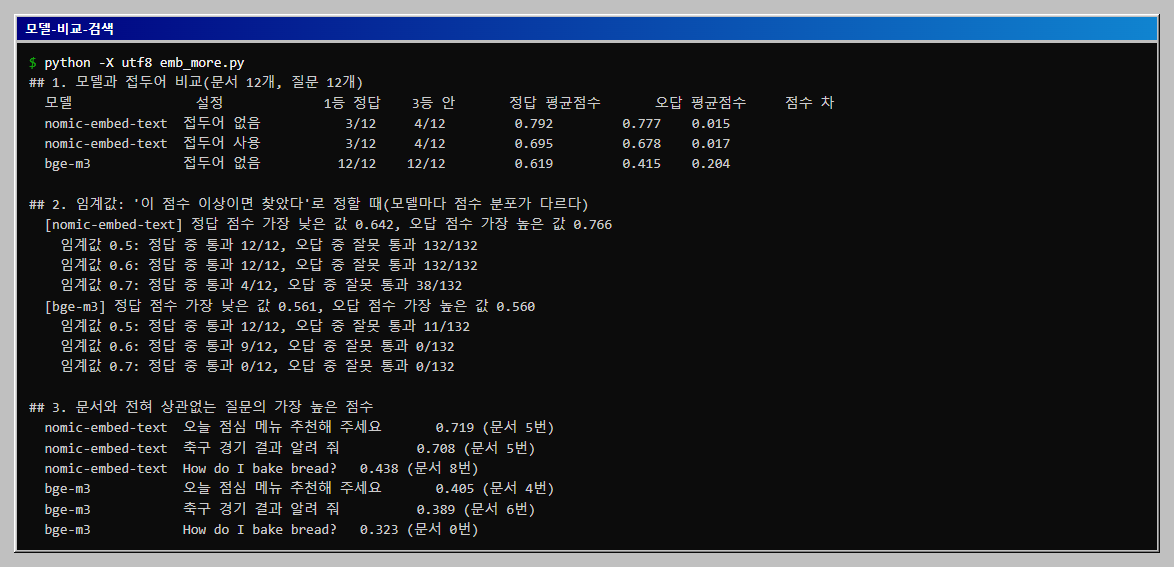
emb_more.py는 아래와 같습니다. ollama pull nomic-embed-text bge-m3로 두 모델을 받아 둡니다.
"""Ollama 임베딩 심화: 한국어 문서 열두 개에서 질문으로 문서를 찾는 시험. 모델 두 개 비교, 접두어(search_query:/search_document:) 유무, 임계값.

준비: Ollama 실행 중, ollama pull nomic-embed-text bge-m3, pip install requests numpy
실행: python -X utf8 emb_more.py   (약 20초)
"""
import numpy as np
import requests

URL = "http://localhost:11434/api/embed"
MODELS = ["nomic-embed-text", "bge-m3"]

DOCS = [
    "비밀번호를 잊어버렸을 때는 로그인 화면의 재설정 링크로 이메일 인증을 거쳐 새 비밀번호를 정합니다.",
    "연차 휴가는 입사 1년 뒤부터 15일이 주어지며 사용 전에 팀장에게 신청해야 합니다.",
    "VPN에 접속하려면 사내 인증서를 설치한 뒤 지정된 주소로 접속하고 일회용 코드를 입력합니다.",
    "노트북을 분실하면 즉시 보안팀에 알리고 원격 삭제를 요청해야 합니다.",
    "회의실 예약은 사내 포털의 달력에서 시간과 인원을 선택해 신청합니다.",
    "출장비는 귀국 후 7일 안에 영수증을 첨부해 정산 시스템에 제출합니다.",
    "서버 디스크 사용률이 90퍼센트를 넘으면 운영팀에 알림이 가고 오래된 로그를 정리합니다.",
    "개인정보가 들어 있는 파일은 암호화한 뒤 승인된 저장소에만 보관해야 합니다.",
    "신입 사원 교육은 입사 첫 주에 보안 수칙과 업무 도구 사용법을 다룹니다.",
    "프린터 용지가 떨어지면 총무팀 보관함에서 가져다 넣고 사용 기록에 적습니다.",
    "소프트웨어 설치가 필요하면 IT 지원 포털에 요청서를 내고 승인을 받아야 합니다.",
    "퇴사자의 계정은 마지막 근무일에 비활성화하고 30일 뒤 삭제합니다.",
]
# (질문, 정답 문서 번호). 질문은 문서의 낱말을 일부러 피해 다르게 적었다.
QUERIES = [
    ("암호가 기억나지 않아요", 0), ("쉬는 날은 며칠이나 쓸 수 있나요", 1), ("집에서 회사 네트워크에 들어가려면", 2),
    ("컴퓨터를 잃어버렸어요", 3), ("회의할 장소를 잡고 싶어요", 4), ("출장 갔다 온 비용 돌려받기", 5),
    ("저장 공간이 거의 찼을 때 어떻게 되나요", 6), ("고객 정보 파일을 어디에 두나요", 7),
    ("새로 들어온 사람은 무엇을 배우나요", 8), ("복사 용지 채우는 방법", 9),
    ("프로그램을 깔고 싶은데요", 10), ("그만둔 직원의 아이디는 어떻게 처리하나요", 11),
]


def embed(texts, model):
    r = requests.post(URL, json={"model": model, "input": texts}, timeout=300).json()
    v = np.array(r["embeddings"], dtype=float)
    return v / np.linalg.norm(v, axis=1, keepdims=True)


def evaluate(model, doc_prefix, query_prefix):
    D = embed([doc_prefix + d for d in DOCS], model)
    Q = embed([query_prefix + q for q, _ in QUERIES], model)
    S = Q @ D.T
    top1 = top3 = 0
    right, wrong = [], []
    for i, (_, gold) in enumerate(QUERIES):
        order = np.argsort(-S[i])
        top1 += order[0] == gold
        top3 += gold in order[:3]
        right.append(S[i, gold])
        wrong.extend(S[i, j] for j in range(len(DOCS)) if j != gold)
    return top1, top3, np.mean(right), np.mean(wrong), min(right), max(wrong), S


NP = "search_document: ", "search_query: "          # nomic-embed-text 가 권하는 접두어
CASES = [("nomic-embed-text", "접두어 없음", "", ""), ("nomic-embed-text", "접두어 사용", *NP), ("bge-m3", "접두어 없음", "", "")]

print("## 1. 모델과 접두어 비교(문서 12개, 질문 12개)")
print(f"  {'모델':<18}{'설정':<12}{'1등 정답':>8}{'3등 안':>8}{'정답 평균점수':>14}{'오답 평균점수':>14}{'점수 차':>9}")
res = {}
for model, label, dp, qp in CASES:
    t1, t3, mr, mw, mn, mx, S = evaluate(model, dp, qp)
    res[(model, label)] = (mn, mx, S, dp, qp)
    print(f"  {model:<18}{label:<12}{t1:>6}/12{t3:>6}/12{mr:>14.3f}{mw:>14.3f}{mr - mw:>9.3f}")

print("\n## 2. 임계값: '이 점수 이상이면 찾았다'로 정할 때(모델마다 점수 분포가 다르다)")
for key in (("nomic-embed-text", "접두어 사용"), ("bge-m3", "접두어 없음")):
    mn, mx, S, _, _ = res[key]
    print(f"  [{key[0]}] 정답 점수 가장 낮은 값 {mn:.3f}, 오답 점수 가장 높은 값 {mx:.3f}")
    for th in (0.5, 0.6, 0.7):
        hits = sum(1 for i, (_, g) in enumerate(QUERIES) if S[i, g] >= th)
        fp = sum(1 for i, (_, g) in enumerate(QUERIES) for j in range(len(DOCS)) if j != g and S[i, j] >= th)
        print(f"    임계값 {th}: 정답 중 통과 {hits}/12, 오답 중 잘못 통과 {fp}/{12 * 11}")

print("\n## 3. 문서와 전혀 상관없는 질문의 가장 높은 점수")
for model, dp, qp in (("nomic-embed-text", *NP), ("bge-m3", "", "")):
    D = embed([dp + d for d in DOCS], model)
    for q in ("오늘 점심 메뉴 추천해 주세요", "축구 경기 결과 알려 줘", "How do I bake bread?"):
        s_ = (embed([qp + q], model) @ D.T)[0]
        print(f"  {model:<18}{q:<22} {s_.max():.3f} (문서 {s_.argmax()}번)")
전체 코드
아래 파일 하나가 벡터 만들기, 가장 가까운 문장, 7x7 표, 질의 검색을 모두 합니다. 그대로 복사해 embed_similarity.py로 저장하고 python -X utf8 embed_similarity.py로 실행합니다.
# embed_similarity.py
"""Ollama 임베딩(nomic-embed-text)으로 한국어 문장 7개의 코사인 유사도를 재고, 질의로 검색해 본다.

준비: Ollama 실행 중, ollama pull nomic-embed-text, pip install requests numpy
실행: python -X utf8 embed_similarity.py
"""
import numpy as np
import requests

URL = "http://localhost:11434/api/embed"
MODEL = "nomic-embed-text"

S = ["비밀번호를 잊어버렸을 때 재설정하는 방법",     # 0
     "계정 암호 복구 절차 안내",                      # 1  0과 같은 뜻
     "점심 메뉴로 김치찌개를 먹었다",                 # 2
     "오늘 저녁에는 된장찌개가 먹고 싶다",            # 3  2와 같은 주제(음식)
     "서버 디스크 사용량이 90퍼센트를 넘었다",        # 4
     "저장 공간이 부족해서 로그 파일을 지웠다",       # 5  4와 같은 주제(용량)
     "다음 주 월요일 오전 10시에 회의가 있습니다"]    # 6


def embed(texts):
    r = requests.post(URL, json={"model": MODEL, "input": texts}, timeout=120).json()
    v = np.array(r["embeddings"])
    return v / np.linalg.norm(v, axis=1, keepdims=True)  # 길이를 1로 맞추면 내적이 코사인 유사도


print("== 1. 벡터 만들기")
E = embed(S)
print("shape", E.shape)

print("== 2. 문장마다 가장 가까운 문장")
M = E @ E.T
for i, s in enumerate(S):
    j = max((k for k in range(len(S)) if k != i), key=lambda k: M[i, k])
    print(f"{i} -> {j} sim {M[i, j]:.3f} | {s[:16]} / {S[j][:16]}")

print("== 3. 전체 유사도 표(7x7)")
print("    " + " ".join(f"{k:5d}" for k in range(len(S))))
for i in range(len(S)):
    print(f"{i:3d} " + " ".join(f"{M[i, k]:5.2f}" for k in range(len(S))))
tri = M[np.triu_indices(len(S), 1)]
print("서로 다른 문장 쌍 21개의 범위: %.3f ~ %.3f" % (tri.min(), tri.max()))

print("== 4. 질의로 검색: 암호를 까먹었어요")
q = embed(["암호를 까먹었어요"])[0]
sc = E @ q
for k in np.argsort(-sc)[:3]:
    print(f"{sc[k]:.3f} {S[k]}")
자주 막히는 곳
| 증상 | 원인과 해결 |
|---|---|
model "nomic-embed-text" not found |
ollama pull nomic-embed-text로 받습니다 |
| 점수가 모두 비슷하게 높습니다 | 이 모델의 특성으로 보입니다. 순위를 쓰고 기준선은 내 데이터로 정합니다 |
| 한글이 깨집니다 | python -X utf8로 실행하고, 한글은 curl이 아니라 Python으로 보냅니다 |
확인 범위
- 해 본 것: 29일에 emb_more.py로 문서 열두 개와 질문 열두 개의 검색 시험을 nomic-embed-text(접두어 유무)와 bge-m3로 실행했습니다. 앞의 확인 내용은 다음과 같습니다. 2026-10-28과 29일, Windows 11 · Ollama 0.32.15,
nomic-embed-text로 문장 7개와 질의 1개를 실행했고, 29일에 전체 스크립트로 점수가 같게 나오는 것(0.852, 0.915, 범위 0.646~0.915)을 확인하고 7x7 표를 더했습니다. - 해 보지 않은 것: 더 많은 문서와 질문에서의 정확도, 긴 문서를 나누는 방법, 벡터 DB 연동.
- 읽을 때 주의: 문장 수가 적어서 이 모델의 한국어 임베딩 품질을 평가한 결과로 볼 수는 없습니다.
이 글은 Ollama와 로컬 LLM 실습 로드맵의 한 단계입니다.
이 글의 다음 단계
- Ollama와 로컬 RAG로 PDF에 묻고 답하기외부 서비스 없이 내 PC에서 PDF 문서에 질문하는 최소 RAG를 파이썬으로 만듭니다. pypdf 추출, 조각 나누기, Ollama 임베딩과 코사인 유사도 검색, 근거 표시, 근거 없는 질문 처리, 문서 속 지시문 실험까지 숫자로 확인합니다.
- 집 PC에서 로컬 AI 돌리기: 메모리로 모델 크기 고르고 속도 재 보기Ollama로 내 PC에서 AI 모델을 돌릴 때 가장 먼저 부딪히는 질문, 어떤 크기의 모델이 내 컴퓨터에 맞는지를 다룹니다. 모델 파일 크기와 메모리의 관계를 계산하고, 2.4B 모델과 31B 모델을 같은 PC에서 돌려 초당 토큰 수를 직접 비교합니다.
이 내용을 팀 교육으로 진행하고 싶으신가요?
인원, 수준, 일정에 맞춰 실습 환경까지 준비해 진행합니다. 대상과 기간을 알려 주시면 구성을 제안해 드립니다.
교육 문의하기메일로 보내실 수도 있습니다: fankh111@gmail.com