로컬에 받아 둔 모델이 여러 개일 때, 어느 것을 언제 쓰면 좋은지 감이 잘 오지 않습니다. 이 글에서는 같은 PC에서 크기가 다른 모델 네 개에 같은 한국어 질문 다섯 개를 보내 속도와 답을 나란히 놓고 봅니다. 질문이 다섯 개뿐이고 평가는 제가 읽고 내린 것이므로, 순위가 아니라 경향을 보는 자료입니다.
준비물
| 항목 | 확인한 값 |
|---|---|
| Ollama | 0.32.15, Windows 11, 메모리 약 96GB(그래픽 공유) |
| 모델 | exaone3.5:2.4b(1.6GB), qwen2.5:3b-instruct-q4_K_M(1.9GB), qwen3.8:27b(17GB), gemma4:31b(20GB) |
| 설정 | temperature 0.2, 답 길이 최대 300토큰, 생각 과정 출력 끔(think: false) |
1. 질문 다섯 개
| # | 질문 | 보려는 것 |
|---|---|---|
| 1 | '회식'과 '회의'의 차이를 한 문장씩 설명해 주세요 | 어휘 이해 |
| 2 | "내일 회의 못 가요"를 정중한 존댓말 이메일 문장으로 바꿔 주세요 | 문체 변환 |
| 3 | 사과 3개에서 2개를 먹고 5개를 더 샀습니다. 숫자만 답하세요 | 계산과 지시 따르기 |
| 4 | '방화벽'을 초등학생에게 두 문장으로 설명해 주세요 | 눈높이 맞추기, 문장 수 |
| 5 | 파이썬으로 리스트의 중복을 제거하는 한 줄 코드를 보여 주세요 | 코드 |
호출은 Python requests로 /api/chat에 보냈습니다. 한글 질문을 Git Bash의 curl로 보내면 깨지는 경우가 있어서 Python을 썼습니다. 실행은 python -X utf8로 합니다.
2. 속도
| 모델 | 28일 | 29일(전체 스크립트) |
|---|---|---|
| exaone3.5:2.4b | 약 104토큰/초 | 100.7토큰/초 |
| qwen2.5:3b | 약 78토큰/초 | 76.6토큰/초 |
| gemma4:31b | 약 15토큰/초 | 12.2토큰/초 |
| qwen3.8:27b | 약 10.5토큰/초 | 13.3토큰/초 |
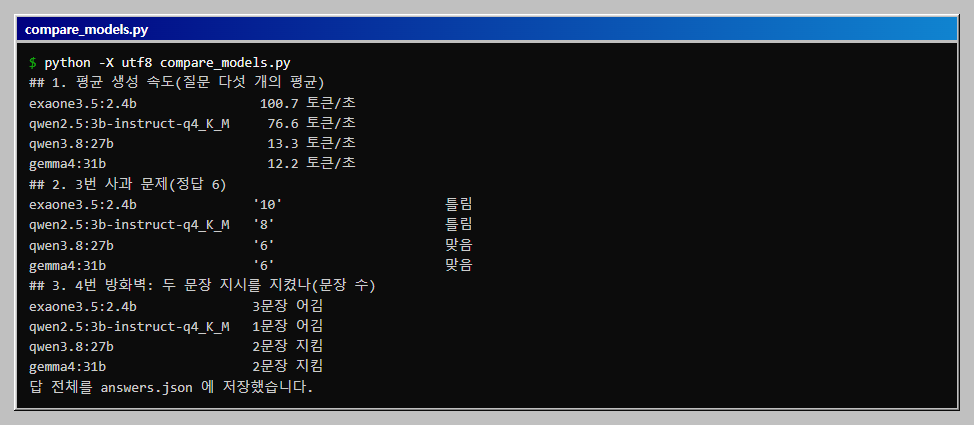
다섯 질문의 초당 토큰 수를 평균 낸 값이고, 모델마다 두 번(날짜별로 한 번씩) 쟀습니다. 작은 모델이 큰 모델보다 7배 안팎 빠른 것은 두 번 다 같았습니다. 반면 28일에는 27B가 31B보다 느렸는데 29일에는 반대로 나왔습니다. 두 큰 모델의 순서는 이 측정으로 정할 수 없고, 둘 다 10~15토큰/초 구간이라고만 읽습니다.
3. 답 비교
3번 사과 문제의 정답은 6입니다.
| 모델 | 답 |
|---|---|
| exaone3.5:2.4b | 10 (틀림) |
| qwen2.5:3b | 8 (틀림) |
| qwen3.8:27b | 6 |
| gemma4:31b | 6 |
두 작은 모델은 "숫자만 답하세요"는 지켰지만 계산이 틀렸습니다. 큰 모델 둘은 맞혔습니다.
1번 어휘 질문에서 qwen2.5:3b는 "'회식'은 회의를 통해 의견을 교환하고 결정을 내리는 과정"이라고 두 낱말을 뒤섞어 설명했습니다. 나머지 세 모델은 회식은 친목을 위한 식사 모임, 회의는 안건을 논의하는 공식적인 자리로 올바르게 구분했습니다.
2번 문체 변환에서 exaone3.5:2.4b는 "내일 회의에 참석하지 못하게 되어 죄송합니다."로 한 문장으로 깔끔하게 답했습니다. 다만 요청에 없던 "대체 방안을 함께 검토해 보시는 것이 어떨까요?"를 덧붙였습니다. qwen3.8:27b와 gemma4:31b는 표현 여러 개를 상황별로 늘어놓았고 gemma는 300토큰 제한에서 답이 잘렸습니다. 한 문장만 필요한 경우에는 큰 모델이 오히려 장황했습니다.
4번 눈높이 질문에서 exaone3.5:2.4b, qwen3.8:27b, gemma4:31b는 집의 문, 경비원, 성벽 같은 비유로 풀었습니다. qwen2.5:3b는 비유 없이 "보안 시스템으로, 컴퓨터를 보호하고…"라는 사전식 한 문장을 내서 초등학생 눈높이에 맞지 않았습니다. "두 문장" 지시는 qwen3.8:27b와 gemma4:31b만 지켰고, exaone은 세 문장, qwen2.5는 한 문장이었습니다.
5번 코드는 네 모델 모두 list(set(...))를 제시했습니다. exaone, qwen3.8, gemma는 순서가 유지되지 않는다는 주의를 덧붙였고 qwen3.8과 gemma는 순서를 지키는 대안(dict.fromkeys 등)까지 보였습니다. qwen2.5:3b는 주의 없이 설명만 했습니다. 한 줄만 보여 달라는 요청에 설명을 더한 점은 네 모델이 같았습니다.
전체 코드
위 질문과 모델로 속도 표, 사과 문제 채점, 문장 수 검사를 한 번에 하는 파일입니다. compare_models.py로 저장하고 python -X utf8 compare_models.py로 실행합니다. 모델 네 개를 받아 두어야 하고 이 PC에서는 약 3분이 걸렸습니다. 답 전체는 같은 폴더의 answers.json에 저장되므로, 2번과 5번 같은 항목은 그 파일을 열어 직접 읽고 판단합니다.
"""같은 한국어 질문 다섯 개를 크기가 다른 모델 네 개에 보내 속도와 답을 저장한다.

준비: Ollama 실행 중, 아래 MODELS 를 ollama pull 로 받아 둔다, pip install requests
주의: 큰 모델(17GB, 20GB)을 메모리에 올리므로 다른 큰 모델이 떠 있으면 느려진다. 약 3~5분.
실행: python -X utf8 compare_models.py   (답 전체는 answers.json 에 저장된다)
"""
import json
import re
import time

import requests

URL = "http://localhost:11434/api/chat"
MODELS = ["exaone3.5:2.4b", "qwen2.5:3b-instruct-q4_K_M", "qwen3.8:27b", "gemma4:31b"]
QS = [
    "'회식'과 '회의'의 차이를 한 문장씩 설명해 주세요.",
    "\"내일 회의 못 가요\"를 정중한 존댓말 이메일 문장으로 바꿔 주세요.",
    "사과 3개에서 2개를 먹고 5개를 더 샀습니다. 숫자만 답하세요.",
    "'방화벽'을 초등학생에게 두 문장으로 설명해 주세요.",
    "파이썬으로 리스트의 중복을 제거하는 한 줄 코드를 보여 주세요.",
]


def ask(model, q):
    body = {"model": model, "stream": False, "think": False,
            "options": {"temperature": 0.2, "num_predict": 300},
            "messages": [{"role": "user", "content": q}]}
    r = requests.post(URL, json=body, timeout=900)
    if r.status_code != 200:                # think 옵션을 못 받는 모델은 옵션 없이 다시 보낸다
        body.pop("think")
        r = requests.post(URL, json=body, timeout=900)
    return r.json()


def sentences(text):
    return len([s for s in re.split(r"(?<=[.?!])\s+", text.strip()) if s])


answers = {}
speed = {}
for m in MODELS:
    answers[m] = []
    rates = []
    for q in QS:
        d = ask(m, q)
        text = d["message"]["content"].strip()
        answers[m].append(text)
        rates.append(d["eval_count"] / (d["eval_duration"] / 1e9))
    speed[m] = sum(rates) / len(rates)
    print(f"{m} 완료", flush=True)

print("\n## 1. 평균 생성 속도(질문 다섯 개의 평균)")
for m in MODELS:
    print(f"{m:<28} {speed[m]:6.1f} 토큰/초")

print("\n## 2. 3번 사과 문제(정답 6)")
for m in MODELS:
    a = answers[m][2]
    print(f"{m:<28} {a[:20]!r:<24} {'맞음' if a.strip().rstrip('.') == '6' else '틀림'}")

print("\n## 3. 4번 방화벽: 두 문장 지시를 지켰나(문장 수)")
for m in MODELS:
    n = sentences(answers[m][3])
    print(f"{m:<28} {n}문장 {'지킴' if n == 2 else '어김'}")

with open("answers.json", "w", encoding="utf-8") as f:
    json.dump(answers, f, ensure_ascii=False, indent=1)
print("\n답 전체를 answers.json 에 저장했습니다.")
29일 재실행에서도 사과 문제(2.4B는 10, 3B는 8, 큰 둘은 6)와 두 문장 지시(큰 둘만 지킴)는 28일과 같은 결과였습니다. 이 둘은 코드로 채점한 값이고, 어휘 설명과 문체 변환은 제가 읽고 판단한 것입니다.
4. 읽는 법
- 빠른 응답이 중요한 일(문체 다듬기, 짧은 요약, 어휘 질문)은 2.4B에서 3B 모델로 충분한 경우가 많았습니다. 단 계산과 정확한 사실이 필요한 일에는 작은 모델 답을 그대로 믿지 않습니다.
- 정확해야 하는 일(계산, 헷갈리는 어휘, 주의사항)은 큰 모델 쪽이 안정적이었습니다. 대신 10에서 15토큰/초로 느리고 답이 길어집니다.
- 지시 따르기는 모델 크기와 별개로 불안정했습니다. 문장 수와 분량 제한은 모델 크기와 상관없이 지켜지지 않았으니, 중요한 제한은 결과를 코드로 검사합니다.
자주 막히는 곳
| 증상 | 원인과 해결 |
|---|---|
think: false에서 오류가 납니다 |
생각 과정 출력을 지원하지 않는 모델일 수 있습니다. 이 글의 스크립트는 오류가 나면 옵션 없이 다시 보내도록 했습니다 |
| 큰 모델의 첫 응답이 매우 느립니다 | 모델을 메모리에 올리는 시간입니다. 두 번째 질문부터 빨라집니다 |
| 답이 중간에 끊깁니다 | 이 글의 답 길이 제한(300토큰)에 걸린 것입니다. num_predict를 늘립니다 |
확인 범위
- 해 본 것: 2026-10-28, Windows 11 · Ollama 0.32.15에서 질문 다섯 개를 모델마다 한 번씩 보냈고, 29일에 전체 스크립트로 한 번 더 실행해 속도와 정답 여부를 다시 확인했습니다.
- 해 보지 않은 것: 긴 글 요약, 번역, 표 해석.
- 읽을 때 주의: 계산 문제만 정답이 정해져 있고, 나머지는 제가 읽어 보고 판단했습니다. 같은 질문도 다시 돌리면 답이 달라질 수 있습니다. 모델의 전체 한국어 실력이 아니라 이 다섯 질문에서 본 차이로 읽어 주시기 바랍니다.
이 글은 Ollama와 로컬 LLM 실습 로드맵의 한 단계입니다.
이 글의 다음 단계
- 집 PC에서 로컬 AI 돌리기: 메모리로 모델 크기 고르고 속도 재 보기Ollama로 내 PC에서 AI 모델을 돌릴 때 가장 먼저 부딪히는 질문, 어떤 크기의 모델이 내 컴퓨터에 맞는지를 다룹니다. 모델 파일 크기와 메모리의 관계를 계산하고, 2.4B 모델과 31B 모델을 같은 PC에서 돌려 초당 토큰 수를 직접 비교합니다.
- Ollama 임베딩으로 한국어 문장 유사도 재기: 잘 되는 곳과 약한 곳nomic-embed-text로 한국어 문장 7개를 768차원 벡터로 바꾸고 코사인 유사도를 계산합니다. 같은 뜻의 문장은 잘 묶이지만 점수가 좁은 범위에 몰리고, 관련 없는 문장도 높게 나오는 약점까지 숫자로 확인합니다.
이 내용을 팀 교육으로 진행하고 싶으신가요?
인원, 수준, 일정에 맞춰 실습 환경까지 준비해 진행합니다. 대상과 기간을 알려 주시면 구성을 제안해 드립니다.
교육 문의하기메일로 보내실 수도 있습니다: fankh111@gmail.com