로컬 모델에 매번 "존댓말로, 짧게 답해 주세요"라고 붙이는 일은 번거롭고 자주 빠뜨립니다. Ollama는 이런 지시와 설정을 Modelfile이라는 파일에 적어 두고, 그 설정이 이미 들어 있는 새 모델 이름을 만들 수 있게 합니다. 모델 파일(가중치)은 복사되지 않고 원본을 그대로 쓰므로 디스크를 더 차지하지 않습니다. 이 글에서는 exaone3.5:2.4b로 사내 IT 도우미를 만들고 원본과 답을 비교합니다.
준비물
| 항목 | 확인한 버전 |
|---|---|
| Ollama | 0.32.15 (Windows 11) |
| 기반 모델 | exaone3.5:2.4b (1.6GB) |
| Python | 3.12.10, requests 2.34.2 (비교 스크립트용) |
1. Modelfile 작성
작업 폴더에 Modelfile이라는 이름으로 만듭니다. 확장자는 붙이지 않습니다.
FROM exaone3.5:2.4b
SYSTEM """당신은 사내 IT 도우미입니다. 항상 존댓말로, 세 문장 이내로 답합니다."""
PARAMETER temperature 0.2
PARAMETER num_ctx 4096
| 줄 | 하는 일 |
|---|---|
FROM |
바탕이 될 모델입니다. ollama list에 있는 이름을 씁니다 |
SYSTEM |
모든 대화 앞에 자동으로 붙는 지시입니다 |
PARAMETER temperature |
낮을수록 같은 질문에 비슷한 답이 나옵니다 |
PARAMETER num_ctx |
한 번에 기억하는 길이(토큰)입니다. 클수록 메모리를 더 씁니다 |
2. 모델 만들고 확인하기
ollama create it-helper -f Modelfile
ollama show it-helper --modelfile
# 기대 출력(일부)
FROM C:\Users\...\.ollama\models\blobs\sha256-d6e077ce...
SYSTEM 당신은 사내 IT 도우미입니다. 항상 존댓말로, 세 문장 이내로 답합니다.
PARAMETER temperature 0.2
PARAMETER num_ctx 4096
PARAMETER repeat_penalty 1
PARAMETER stop [|endofturn|]
내가 쓰지 않은 repeat_penalty와 stop 줄은 원본 모델이 가진 기본 설정이 따라온 것입니다. FROM이 가리키는 파일이 원본 모델의 파일과 같은 해시이므로 가중치가 복사되지 않은 것을 알 수 있습니다.
3. 원본과 비교하기
같은 질문을 두 모델에 보냅니다. 질문은 회사 노트북 비밀번호를 잊어버렸습니다. 어떻게 해야 하나요?입니다.
import requests

q = "회사 노트북 비밀번호를 잊어버렸습니다. 어떻게 해야 하나요?"
for m in ["exaone3.5:2.4b", "it-helper"]:
    d = requests.post("http://localhost:11434/api/chat", json={
        "model": m, "stream": False,
        "messages": [{"role": "user", "content": q}]}).json()
    print(m, d["eval_count"], "tokens\n", d["message"]["content"], "\n")
Windows에서 한글을 출력하려면 python -X utf8 compare.py로 실행합니다.
| 모델 | 만든 토큰 수 | 답의 모양 |
|---|---|---|
| exaone3.5:2.4b | 407 | 번호 목록 세 항목, 굵은 글씨, 운영체제별 메뉴 경로 |
| it-helper | 79 | 존댓말 네 문장, 목록 없음 |
it-helper는 "세 문장 이내" 지시를 정확히 지키지는 못했습니다. 문장이 네 개였습니다. 작은 모델은 이런 개수 제한을 느슨하게 따릅니다. 그래도 길이가 5분의 1로 줄고 말투가 일정해졌으며, 답이 짧아진 만큼 같은 PC에서 응답 시간도 줄어듭니다.
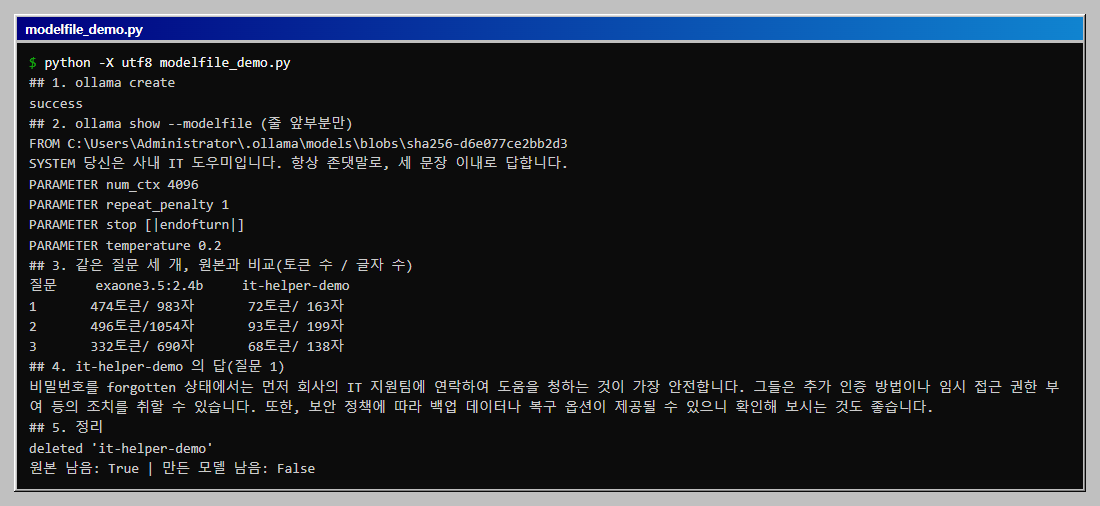
질문을 세 개로 늘려 같은 방식으로 다시 쟀습니다(아래 전체 스크립트). 답의 길이는 세 질문 모두 원본의 약 1/5이었습니다.
| 질문 | 원본(토큰/글자) | it-helper-demo(토큰/글자) |
|---|---|---|
| 노트북 비밀번호 분실 | 474 / 983 | 72 / 163 |
| VPN이 자꾸 끊김 | 496 / 1054 | 93 / 199 |
| 프린터 출력 안 됨 | 332 / 690 | 68 / 138 |
답을 읽어 보니 한 가지 문제도 있었습니다. 첫 질문의 답에 비밀번호를 forgotten 상태에서는처럼 영어 단어가 섞여 나왔습니다. 작은 모델이 지시를 따라 길이는 줄였지만 문장 품질까지 좋아진 것은 아닙니다. Modelfile은 말투와 길이를 정해 주는 도구이고, 답의 정확성은 모델 크기와 질문에 달려 있습니다.
4. 정리하기
ollama rm it-helper
ollama rm은 만든 모델의 설정만 지우고, 원본 exaone3.5:2.4b는 그대로 둡니다. 전체 스크립트는 삭제 뒤 ollama list에 원본이 남아 있는지를 출력합니다.
전체 코드
Modelfile 쓰기, 모델 만들기, 설정 확인, 세 질문 비교, 정리까지 한 번에 실행하는 파일입니다. modelfile_demo.py로 저장하고 python -X utf8 modelfile_demo.py로 실행합니다. 만든 모델의 이름은 it-helper-demo이고 끝에서 이 모델만 지웁니다. 실행이 끝나면 임시로 쓴 Modelfile도 지웁니다.
"""Ollama Modelfile 로 사내 IT 도우미 모델을 만들고, 원본과 같은 질문 세 개로 답을 비교한 뒤 지운다.

준비: Ollama 실행 중, ollama pull exaone3.5:2.4b, pip install requests
주의: 만든 모델 이름은 it-helper-demo 이고 끝에서 이 모델만 지운다. 원본 모델은 건드리지 않는다.
실행: python -X utf8 modelfile_demo.py   (약 40초)
"""
import subprocess
from pathlib import Path

import requests

BASE = "exaone3.5:2.4b"
NEW = "it-helper-demo"
URL = "http://localhost:11434/api/chat"
QS = ["회사 노트북 비밀번호를 잊어버렸습니다. 어떻게 해야 하나요?",
      "VPN이 자꾸 끊깁니다. 무엇부터 확인하면 되나요?",
      "프린터에서 출력이 안 됩니다. 어떻게 하죠?"]

MODELFILE = f'''FROM {BASE}
SYSTEM """당신은 사내 IT 도우미입니다. 항상 존댓말로, 세 문장 이내로 답합니다."""
PARAMETER temperature 0.2
PARAMETER num_ctx 4096
'''
Path("Modelfile").write_text(MODELFILE, encoding="utf-8")

print("## 1. ollama create")
r = subprocess.run(["ollama", "create", NEW, "-f", "Modelfile"], capture_output=True, text=True, encoding="utf-8")
print("success" if "success" in (r.stdout + r.stderr) else "실패: " + r.stderr)   # 진행 표시 제어문자는 출력하지 않는다

print("## 2. ollama show --modelfile (줄 앞부분만)")
out = subprocess.run(["ollama", "show", NEW, "--modelfile"], capture_output=True, text=True, encoding="utf-8").stdout
for line in out.splitlines():
    if line.startswith(("FROM", "SYSTEM", "PARAMETER")):
        print(line[:70])


def ask(model, q):
    d = requests.post(URL, json={"model": model, "stream": False, "options": {"seed": 1},
                                 "messages": [{"role": "user", "content": q}]}, timeout=300).json()
    text = d["message"]["content"].strip()
    return d["eval_count"], len(text), text


print("## 3. 같은 질문 세 개, 원본과 비교(토큰 수 / 글자 수)")
print(f"{'질문':<4} {BASE:>16} {NEW:>18}")
last = {}
for i, q in enumerate(QS, 1):
    a = ask(BASE, q)
    b = ask(NEW, q)
    last[i] = b[2]
    print(f"{i:<4} {a[0]:>6}토큰/{a[1]:>4}자 {b[0]:>8}토큰/{b[1]:>4}자")

print("## 4. it-helper-demo 의 답(질문 1)")
print(last[1])

print("## 5. 정리")
print(subprocess.run(["ollama", "rm", NEW], capture_output=True, text=True, encoding="utf-8").stdout.strip())
names = subprocess.run(["ollama", "list"], capture_output=True, text=True, encoding="utf-8").stdout
print("원본 남음:", BASE in names, "| 만든 모델 남음:", NEW in names)
Path("Modelfile").unlink()
자주 막히는 곳
| 증상 | 원인과 해결 |
|---|---|
ollama create가 pull model manifest 오류를 냅니다 |
FROM의 모델 이름이 ollama list에 없습니다. 먼저 ollama pull로 받습니다 |
| 터미널에서 curl로 한글 질문을 보냈더니 엉뚱한 답이 나옵니다 | Windows Git Bash의 curl이 한글을 깨뜨려 보낸 경우가 있었습니다. 같은 질문이 Python에서는 정상 처리되었습니다. 한글 질문은 Python이나 파일(-d @파일)로 보냅니다 |
| 지시를 안 따릅니다 | 모델이 작을수록 개수 제한 같은 세밀한 지시를 놓칩니다. 지시를 더 짧고 단순하게 쓰거나 더 큰 모델로 바꿔 비교합니다 |
| 답이 중간에 끊깁니다 | num_ctx가 작은 경우입니다. 값을 올리고 다시 만듭니다 |
이어서 해 볼 것
- temperature 비교: 0.2와 1.0으로 같은 질문을 여러 번 보내 답이 얼마나 달라지는지 봅니다. 이 글에서는 시험하지 않았습니다.
- Open WebUI에서 쓰기: 만든 모델은
ollama list에 나타나므로 Open WebUI의 모델 선택 목록에서도 고를 수 있을 것으로 보이지만 확인하지 않았습니다.
확인 범위
- 해 본 것: 2026-10-28, Windows 11 · Ollama 0.32.15에서
ollama create,ollama show --modelfile, API 호출,ollama rm을 실행했습니다. 29일에 질문 세 개로 전체 스크립트를 실행했고, 삭제 뒤ollama list에서 원본이 남아 있는 것까지 확인했습니다. 질문마다 한 번씩 보낸 결과입니다. - 해 보지 않은 것: Linux와 macOS, 다른 기반 모델, 여러 번 반복한 평균.
- 읽을 때 주의: 답은 실행마다 달라지므로 토큰 수는 어림값으로 봅니다.
이 글은 Ollama와 로컬 LLM 실습 로드맵의 한 단계입니다.
이 글의 다음 단계
- 집 PC에서 로컬 AI 돌리기: 메모리로 모델 크기 고르고 속도 재 보기Ollama로 내 PC에서 AI 모델을 돌릴 때 가장 먼저 부딪히는 질문, 어떤 크기의 모델이 내 컴퓨터에 맞는지를 다룹니다. 모델 파일 크기와 메모리의 관계를 계산하고, 2.4B 모델과 31B 모델을 같은 PC에서 돌려 초당 토큰 수를 직접 비교합니다.
- 한국어로 물어 본 로컬 모델 4종 비교: 2.4B, 3B, 27B, 31B같은 PC에서 exaone3.5 2.4B, qwen2.5 3B, qwen3.8 27B, gemma4 31B에 한국어 질문 다섯 개를 보내 속도와 답을 비교합니다. 작은 모델이 틀린 곳과 큰 모델이 느린 만큼 얻는 것을 실제 답으로 확인합니다.
이 내용을 팀 교육으로 진행하고 싶으신가요?
인원, 수준, 일정에 맞춰 실습 환경까지 준비해 진행합니다. 대상과 기간을 알려 주시면 구성을 제안해 드립니다.
교육 문의하기메일로 보내실 수도 있습니다: fankh111@gmail.com