로컬 모델은 처음 부를 때 디스크에서 메모리로 올라오는 데 시간이 걸립니다. 그래서 Ollama는 답을 마친 뒤에도 모델을 잠시 메모리에 둡니다. 이 시간이 keep_alive입니다. 길게 잡으면 다음 질문이 빠르지만 메모리를 계속 차지하고, 짧게 잡으면 메모리를 돌려주지만 다음 질문이 느립니다. 이 글에서는 값을 바꿔 가며 그 차이를 잽니다.
같은 모델에 요청이 몰릴 때의 처리량은 동시 요청 처리량 재기 글에서 따로 측정했습니다.
준비물
| 항목 | 확인한 값 |
|---|---|
| Ollama | 0.32.15 (Windows 11) |
| 모델 | exaone3.5:2.4b |
| 도구 | Python 3.12.10, requests |
1. 현재 설정 보기
ollama ps
UNTIL 열이 그 모델이 메모리에서 내려가는 시각입니다. 이 PC에서는 Forever로 표시됐습니다. 사용자 환경 변수에 OLLAMA_KEEP_ALIVE=-1이 들어 있었기 때문입니다(시스템 환경 변수에는 없었습니다). 변수가 없으면 기본값은 5분으로 알려져 있지만, 이 PC에서는 변수를 지워 확인하지 않았습니다.
2. 호출마다 값 바꾸기
keep_alive는 요청마다 줄 수 있고, 환경 변수보다 우선합니다. 숫자는 초, 문자열은 "20s", "5m" 같은 시간, -1은 무기한, 0은 답한 직후 내리기입니다.
import requests, subprocess, time

U = "http://localhost:11434/api/generate"

def ps():
    out = subprocess.run(["ollama", "ps"], capture_output=True, text=True).stdout.splitlines()
    return [" ".join(l.split()) for l in out[1:] if l.startswith("exaone")]

def go(keep):
    d = requests.post(U, json={"model": "exaone3.5:2.4b", "prompt": "안녕", "stream": False,
                               "keep_alive": keep, "options": {"num_predict": 5}}).json()
    return round(d["load_duration"] / 1e9, 2)

print("keep_alive=0    load", go(0), "| after:", ps())
print("keep_alive=20s  load", go("20s"), "| after:", ps())
print("second call     load", go("20s"))
time.sleep(25)
print("after 25s idle:", ps())
print("reload          load", go(0))
3. 결과
# 기대 출력(이 PC)
keep_alive=0    load 4.09 | after: []
keep_alive=20s  load 2.3  | after: ['exaone3.5:2.4b ... 100% GPU ... 19 seconds from now']
second call     load 0.0
after 25s idle: []
reload          load 2.3
| 상황 | 불러오는 시간 | ollama ps |
|---|---|---|
keep_alive=0으로 호출 |
4.09초 (메모리에 없던 상태) | 목록이 비어 있음 |
"20s"로 호출 |
2.3초 | 19 seconds from now로 카운트다운 |
| 20초 안에 다시 호출 | 0.0초 | 시간이 다시 20초로 갱신됨 |
| 25초 동안 쉼 | - | 목록이 비어 있음 |
| 내려간 뒤 다시 호출 | 2.3초 | - |
- 0초로 부르면 바로 내려갑니다. 답을 받자마자
ollama ps가 비어 있었습니다. - 연속 호출에서는 불러오는 시간이 사라집니다. 두 번째 호출은 0.0초였습니다.
- 내려간 뒤에는 불러오는 시간이 다시 듭니다. 이 모델은 2.3초였고, 큰 모델일수록 길어집니다. 앞선 글에서 31B 모델을 처음 올릴 때는 26초가 걸렸습니다.
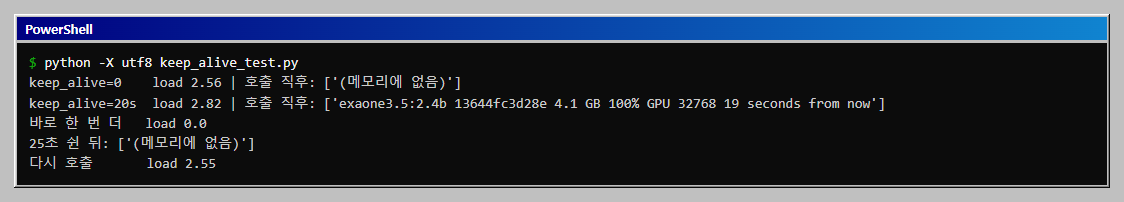
29일에 전체 스크립트로 다시 실행해도 결과는 같았습니다. 불러오는 시간만 2.5~2.8초로 처음보다 조금 길었습니다.
4. 어떻게 고를까
| 상황 | 권장 |
|---|---|
| 하루 종일 쓰는 개인 PC, 메모리가 넉넉함 | -1(무기한)이나 긴 시간 |
| 메모리가 빠듯하고 가끔 씀 | 기본값이나 "2m" 정도 |
| 한 번 돌리고 메모리를 비우고 싶음 | 호출에 keep_alive: 0 |
| 여러 모델을 번갈아 씀 | 짧게 잡아 두 모델이 동시에 메모리를 차지하지 않게 함 |
환경 변수로 전체 기본값을 바꿀 때는 Ollama를 완전히 종료했다가 다시 시작해야 합니다. 이 글에서는 환경 변수를 바꾸지 않았습니다.
더 해 보기: 표기, 서버 기본값, 모델 크기별 비용
위 실험에서 한 걸음 더 나가, 값을 어떻게 적느냐에 따라 달라지는 점, 서버 전체 기본값(OLLAMA_KEEP_ALIVE)과 요청값 중 무엇이 이기는지, 모델이 커질수록 첫 호출이 얼마나 비싸지는지를 확인했습니다. 본 서비스(11434)를 건드리지 않으려고 11501 포트에 임시 서버를 따로 띄웠고, 그 서버의 기본값을 OLLAMA_KEEP_ALIVE=10s로 주었습니다(keep_alive_more.py).
값의 표기
/api/ps가 알려 주는 expires_at(내려갈 시각)으로 호출 직후 남은 시간을 읽었습니다.
요청의 keep_alive |
결과 |
|---|---|
0 또는 "0" |
메모리에 없음. 응답 직후 바로 내려감 |
30 (숫자) |
약 30초 뒤 내려감. 숫자는 초로 읽힘 |
"30s" |
약 30초 뒤 내려감 |
"2m" |
약 120초 뒤 내려감 |
"1h" |
약 3600초 뒤 내려감 |
-1 (숫자) |
무기한. 내려가지 않음 |
"-1" (문자열) |
오류: time: missing unit in duration "-1" |
| 지정 안 함 | 서버 기본값(이 글에서는 10초)을 따름. 약 10초 뒤 내려감 |
가장 조심할 것은 문자열 "-1"입니다. 숫자 -1은 "무기한"이지만 따옴표를 붙인 문자열 "-1"은 단위가 없는 기간으로 읽혀 오류가 납니다. 같은 값이 JSON 타입 하나에 따라 정반대로 처리되므로, 무기한은 숫자 -1로 씁니다. 숫자 30과 문자열 "30s"는 같았습니다.
서버 기본값과 요청값의 우선순위
지정 없이 호출하면 서버 기본값(10초)이 적용되었습니다. 호출 5초 뒤에는 "약 5초 뒤 내려감"으로 남은 시간이 줄고 있었고, 15초 뒤에는 모델이 메모리에서 사라졌습니다. 같은 서버에서 요청에 keep_alive: "1m"을 주면 서버 기본값이 아니라 요청값이 이겨서, 15초가 지난 뒤에도 약 45초가 남아 있었습니다(60초에서 15초 지남). 서버 설정은 기본값이고 요청마다 덮어쓸 수 있다는 뜻입니다. 여러 프로그램이 한 서버를 나눠 쓸 때, 각 프로그램이 자기 요청에 값을 주면 서로 영향을 주지 않습니다.
모델이 클수록 첫 호출이 비쌉니다
세 모델을 각각 내린 뒤 첫 호출과 바로 이어서 한 호출의 시간을 쟀습니다.
| 모델 | 첫 호출 불러오기 | 첫 호출 전체 | 이어서 부른 전체 |
|---|---|---|---|
exaone3.5:2.4b (1.6GB) |
2.9초 | 3.0초 | 0.1초 |
qwen2.5:3b-instruct-q4_K_M (1.9GB) |
4.9초 | 5.1초 | 0.1초 |
gemma4:31b (20GB) |
44.3초 | 45.0초 | 0.6초 |
큰 모델은 첫 호출에 44초가 걸렸고 이어서 부르면 1초가 되지 않았습니다. 작은 모델은 3~5초라서 keep_alive: 0으로 매번 내려도 견딜 수 있지만, 20GB 모델은 사용자가 매번 45초를 기다리게 됩니다. 큰 모델은 keep_alive를 넉넉히 주고 메모리 압박이 있을 때만 줄입니다. 28일에 본 31B의 로딩 26초와 이번의 44초가 다른 것은 이번에 다른 모델 두 개가 이미 메모리에 올라 있고 한 번씩만 재서 생긴 차이로 추정합니다.
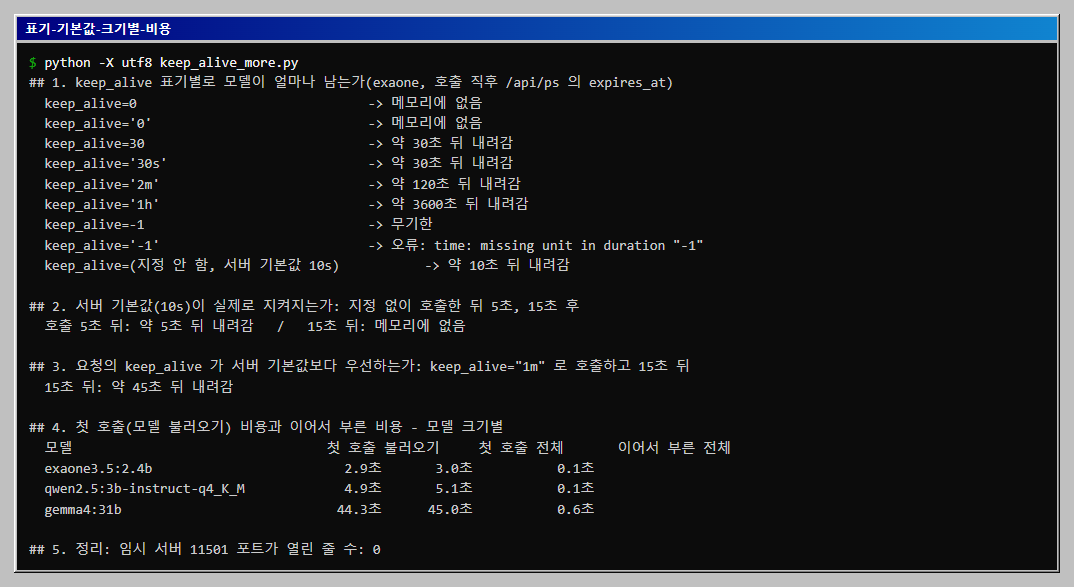
keep_alive_more.py(아래)는 임시 서버를 띄우고 끝에서 그 서버만 끕니다. 큰 모델을 한 번 더 올리므로 메모리가 넉넉한 PC에서만 실행합니다.
"""Ollama keep_alive 심화: 값의 여러 표기, 서비스 기본값(OLLAMA_KEEP_ALIVE)과 요청값의 우선순위, 모델 크기별 첫 호출 비용.

준비: Ollama 설치, ollama pull exaone3.5:2.4b qwen2.5:3b-instruct-q4_K_M gemma4:31b, pip install requests
주의: 본 서비스(11434)는 건드리지 않고, 11501 포트에 임시 서버를 따로 띄운다(OLLAMA_KEEP_ALIVE=10s). 끝에서 이 서버만 끈다.
      큰 모델(20GB)을 임시 서버가 한 번 더 올리므로 메모리가 넉넉한 PC에서만 실행한다.
실행: python -X utf8 keep_alive_more.py   (약 3분)
"""
import os
import subprocess
import time
from datetime import datetime, timezone

import requests

PORT = 11501
URL = f"http://127.0.0.1:{PORT}"
SMALL, MID, BIG = "exaone3.5:2.4b", "qwen2.5:3b-instruct-q4_K_M", "gemma4:31b"

env = dict(os.environ, OLLAMA_HOST=f"127.0.0.1:{PORT}", OLLAMA_KEEP_ALIVE="10s")
srv = subprocess.Popen(["ollama", "serve"], env=env, stdout=subprocess.DEVNULL, stderr=subprocess.DEVNULL)
for _ in range(30):
    try:
        requests.get(URL + "/api/version", timeout=1)
        break
    except requests.RequestException:
        time.sleep(1)


def gen(model, keep=None, n=5):
    body = {"model": model, "prompt": "안녕", "stream": False, "options": {"num_predict": n}}
    if keep is not None:
        body["keep_alive"] = keep
    t = time.time()
    d = requests.post(URL + "/api/generate", json=body, timeout=600).json()
    if "error" in d:
        return d["error"], None
    return d["load_duration"] / 1e9, time.time() - t


def remaining(model):
    """/api/ps 의 expires_at 에서 지금까지 남은 초(없으면 None)"""
    for m in requests.get(URL + "/api/ps").json()["models"]:
        if m["name"] == model:
            e = datetime.fromisoformat(m["expires_at"].replace("Z", "+00:00"))
            return (e - datetime.now(timezone.utc)).total_seconds()
    return None


def fmt(s):
    return "메모리에 없음" if s is None else ("무기한" if s > 3e8 else f"약 {s:.0f}초 뒤 내려감")


try:
    print("## 1. keep_alive 표기별로 모델이 얼마나 남는가(exaone, 호출 직후 /api/ps 의 expires_at)")
    for keep in (0, "0", 30, "30s", "2m", "1h", -1, "-1", None):
        subprocess.run(["ollama", "stop", SMALL], env=env, capture_output=True)
        err, _ = gen(SMALL, keep)
        label = "(지정 안 함, 서버 기본값 10s)" if keep is None else repr(keep)
        print(f"  keep_alive={label:<30} -> {('오류: ' + str(err)[:70]) if isinstance(err, str) else fmt(remaining(SMALL))}")

    print("\n## 2. 서버 기본값(10s)이 실제로 지켜지는가: 지정 없이 호출한 뒤 5초, 15초 후")
    subprocess.run(["ollama", "stop", SMALL], env=env, capture_output=True)
    gen(SMALL)
    time.sleep(5)
    a = remaining(SMALL)
    time.sleep(10)
    b = remaining(SMALL)
    print(f"  호출 5초 뒤: {fmt(a)}   /   15초 뒤: {fmt(b)}")

    print("\n## 3. 요청의 keep_alive 가 서버 기본값보다 우선하는가: keep_alive=\"1m\" 로 호출하고 15초 뒤")
    gen(SMALL, "1m")
    time.sleep(15)
    print(f"  15초 뒤: {fmt(remaining(SMALL))}")

    print("\n## 4. 첫 호출(모델 불러오기) 비용과 이어서 부른 비용 - 모델 크기별")
    print(f"  {'모델':<28}{'첫 호출 불러오기':>16}{'첫 호출 전체':>12}{'이어서 부른 전체':>16}")
    for m in (SMALL, MID, BIG):
        subprocess.run(["ollama", "stop", m], env=env, capture_output=True)
        l1, t1 = gen(m, "1m")
        l2, t2 = gen(m, "1m")
        print(f"  {m:<28}{l1:>14.1f}초{t1:>10.1f}초{t2:>14.1f}초")
        subprocess.run(["ollama", "stop", m], env=env, capture_output=True)
finally:
    srv.terminate()
    srv.wait(timeout=30)
    time.sleep(1)
    r = subprocess.run(["netstat", "-ano"], capture_output=True, text=True).stdout
    print("\n## 5. 정리: 임시 서버 11501 포트가 열린 줄 수:", sum(1 for l in r.splitlines() if f":{PORT} " in l and "LISTENING" in l))
전체 코드
아래 파일 하나가 이 글의 시험을 모두 실행합니다(약 40초). 그대로 복사해 keep_alive_test.py로 저장하고 python -X utf8 keep_alive_test.py로 실행합니다. 이 모델만 내리고 올리며 다른 모델과 서비스 설정은 건드리지 않습니다.
# keep_alive_test.py
"""Ollama keep_alive: 모델을 메모리에 얼마나 남길지 호출마다 정하고, ollama ps 로 확인한다.

준비: Ollama 실행 중, ollama pull exaone3.5:2.4b, pip install requests
주의: 이 파일은 exaone3.5:2.4b 만 건드린다. 서비스 전체 설정(OLLAMA_KEEP_ALIVE)은 바꾸지 않는다.
실행: python -X utf8 keep_alive_test.py   (약 40초)
"""
import subprocess
import time
import requests

URL = "http://localhost:11434/api/generate"
MODEL = "exaone3.5:2.4b"


def ps():
    out = subprocess.run(["ollama", "ps"], capture_output=True, text=True).stdout.splitlines()
    rows = [" ".join(l.split()) for l in out[1:] if l.startswith("exaone")]
    return rows or ["(메모리에 없음)"]


def go(keep_alive):
    d = requests.post(URL, json={"model": MODEL, "prompt": "안녕", "stream": False,
                                 "keep_alive": keep_alive, "options": {"num_predict": 5}}, timeout=120).json()
    return round(d["load_duration"] / 1e9, 2)   # 모델을 불러오는 데 걸린 초(이미 올라 있으면 0)


subprocess.run(["ollama", "stop", MODEL], capture_output=True)   # 깨끗한 상태에서 시작
print("keep_alive=0    load", go(0), "| 호출 직후:", ps())
time.sleep(1)
print("keep_alive=20s  load", go("20s"), "| 호출 직후:", ps())
print("바로 한 번 더   load", go("20s"))
time.sleep(25)
print("25초 쉰 뒤:", ps())
print("다시 호출       load", go("0"))
자주 막히는 곳
| 증상 | 원인과 해결 |
|---|---|
호출에서 keep_alive: 0을 줬는데 모델이 남아 있습니다 |
다른 프로그램이 같은 모델을 동시에 쓰고 있을 수 있습니다. 이 글에서는 확인하지 않았습니다 |
ollama ps에 Forever가 보입니다 |
OLLAMA_KEEP_ALIVE=-1 또는 호출의 -1 때문입니다. 환경 변수 위치를 확인합니다 |
| 모델을 바로 내리고 싶습니다 | ollama stop 모델이름 |
확인 범위
- 해 본 것: 29일에 임시 서버(11501)로 keep_alive 표기 아홉 가지, 서버 기본값과 요청값의 우선순위, 모델 세 개의 첫 호출 시간을 확인했습니다. 앞의 확인 내용은 다음과 같습니다. 2026-10-28과 29일, Windows 11 · Ollama 0.32.15, 모델
exaone3.5:2.4b로 위 스크립트를 실행했고 29일에 전체 스크립트로 다시 확인했습니다. - 해 보지 않은 것: 서비스 전체 기본값(OLLAMA_KEEP_ALIVE)을 본 서비스에서 바꾸는 것, 모델 여러 개가 동시에 올라 있을 때의 메모리 압박으로 인한 강제 해제, 환경 변수를 지웠을 때의 기본 동작, Linux와 macOS.
- 읽을 때 주의: 불러오는 시간은 모델 크기와 디스크 상태에 따라 달라집니다. 한 번 잰 값입니다.
이 글은 Ollama와 로컬 LLM 실습 로드맵의 한 단계입니다.
이 글의 다음 단계
- Ollama num_ctx를 키우면 메모리는 얼마나 늘까: 2K, 8K, 32K 측정같은 2.4B 모델을 컨텍스트 길이 2048, 8192, 32768로 올려 보고 ollama ps의 메모리 사용량, 불러오는 시간, 생성 속도를 비교합니다. 긴 문서를 다루려고 num_ctx를 키울 때 치르는 비용을 숫자로 봅니다.
- 집 PC에서 로컬 AI 돌리기: 메모리로 모델 크기 고르고 속도 재 보기Ollama로 내 PC에서 AI 모델을 돌릴 때 가장 먼저 부딪히는 질문, 어떤 크기의 모델이 내 컴퓨터에 맞는지를 다룹니다. 모델 파일 크기와 메모리의 관계를 계산하고, 2.4B 모델과 31B 모델을 같은 PC에서 돌려 초당 토큰 수를 직접 비교합니다.
이 내용을 팀 교육으로 진행하고 싶으신가요?
인원, 수준, 일정에 맞춰 실습 환경까지 준비해 진행합니다. 대상과 기간을 알려 주시면 구성을 제안해 드립니다.
교육 문의하기메일로 보내실 수도 있습니다: fankh111@gmail.com